 10 min di lettura
Da 800 millisecondi a 0,08 secondi: il cambio che il tuo Mac aspettava
Sottotitolo: Rapid-MLX usa il framework nativo Apple anziché llama.cpp. Sui modelli giusti, la differenza si sente.
📌 Se usi Ollama sul tuo Mac con chip M per girare modelli locali, questo articolo potrebbe farti riconsiderare il tuo setup. Non si parla di nuovo hardware: si parla di quanto stavi lasciando sul tavolo con quello che hai già.
Hai un Mac con chip M. Magari un M2, un M3, forse anche un M4 o un M5. Lo usi per girare qualche modello locale — Ollama, un file GGUF, qualcosa che risponde senza mandare dati a nessun server. E a un certo punto hai pensato: “va bene, fa il suo lavoro, ma è un po’ lento”.
Non era l’hardware il problema.
Era come il software stava parlandogli.
Il 28 luglio 2026 è uscita la versione 0.11.1 di Rapid-MLX, un motore di inferenza open source costruito interamente sul framework nativo di Apple. Sul repository GitHub campeggia il claim: 4,2x più veloce di Ollama. Una cifra che fa rumore.
La realtà è più sfumata — e più interessante — di così. Te la racconto.
Riepilogo Articolo - Luca Cazzaniga
Perché il Mac M era già una macchina da inferenza seria
Per capire cosa sta succedendo, devi capire una cosa sull’architettura del tuo Mac.
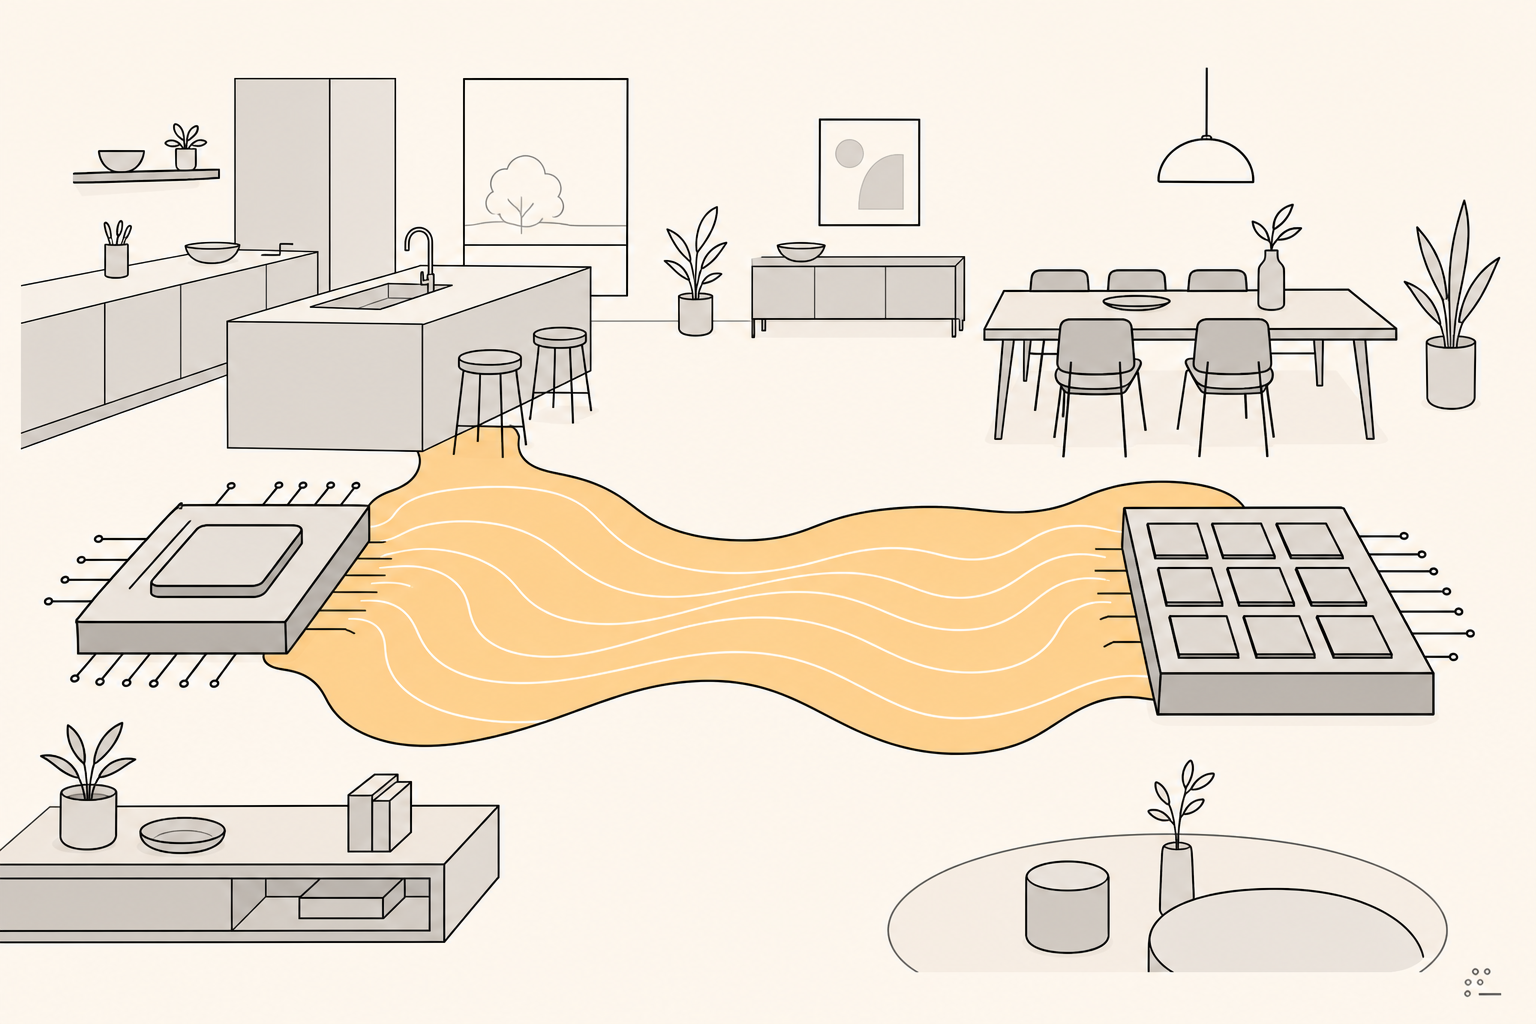
I chip Apple Silicon — da M1 in poi — hanno una caratteristica che li rende particolarmente adatti a far girare modelli AI: la memoria unificata. Significa che CPU e GPU condividono lo stesso spazio fisico di memoria, senza dover trasferire i dati da un posto all’altro.
Immagina una cucina e una sala da pranzo in open space. Il cibo — i dati del modello — non deve mai viaggiare da un locale all’altro: è già dove serve, sempre. I chip tradizionali, invece, lavorano come due stanze separate: ogni volta che la cucina prepara qualcosa per la sala, c’è un tragitto da fare. Quel tragitto ha un costo in tempo.
I runtime di inferenza classici — come il backend llama.cpp che Ollama ha usato finora — non sono stati scritti pensando specificamente a questa architettura. Funzionano, ma non sfruttano fino in fondo quello che il chip offre. Rapid-MLX, invece, è costruito sopra MLX — il framework open source che Apple stessa ha sviluppato e mantiene attraverso il suo team di ricerca, con quasi 28.000 stelle su GitHub. Un framework pensato nativamente per la memoria unificata, per quel chip specifico.
La scelta tecnica è precisa: Rapid-MLX usa solo “pure MLX kernels”, niente llama.cpp. Quella scelta è esattamente il motivo del delta di velocità.
Il “4,2x”: cos’è vero e cosa no
Partiamo dal claim ufficiale. Su GitHub e nelle comunicazioni del progetto, Rapid-MLX dichiara di essere “4,2x più veloce di Ollama”. Il numero esiste, è pubblicato, è replicabile — in una condizione specifica.
Cosa dice invece PyPI, il registro ufficiale dove il pacchetto è distribuito? “2-4x faster than Ollama”. Un range, non un picco. Questa divergenza tra i due canali ufficiali del progetto stesso è già la prima spia che il 4,2x è il caso limite, non la media.
I benchmark indipendenti confermano questa lettura. Il blog andrew.ooo ha pubblicato il 13 maggio 2026 un test con metodologia esplicita e hardware dichiarato. I numeri:
- Qwen3.5-9B su M3 Ultra: 108 tok/s (Rapid-MLX) vs 41 tok/s (Ollama) = 2,6x
- Phi-4 Mini 14B su M3 Ultra: 180 tok/s vs 56 tok/s = 3,2x
- Qwen3.5-27B su M5 Max: 64 tok/s vs 39 tok/s = 1,6x
- Gemma 4 26B su M3 Ultra: 85 tok/s vs 68 tok/s = 1,3x
Il 4,2x come picco? Misurato su M3 Ultra — l’hardware più potente che puoi mettere in casa — contro il backend llama.cpp di Ollama. Riproducibile? No, non come dato medio.
Qui c’è però qualcosa di importante che i numeri rivelano: il fattore che conta di più non è il Mac che hai, ma il modello che carichi. Sullo stesso M3 Ultra, i risultati vanno da 1,3x a 3,2x a seconda del modello scelto. Il chip è costante; il delta cambia in base al modello. Questo significa che quando scegli cosa scaricare, stai scegliendo anche quanta velocità ti aspetti di guadagnare.
La metrica che conta davvero per il lavoro quotidiano
C’è una seconda cifra nel confronto che viene spesso sovrapposta al throughput, ma misura qualcosa di completamente diverso: il TTFT, il Time To First Token — quanto tempo passa dall’invio del prompt alla prima parola della risposta.
Su prompt già in cache (prompt che hai già inviato o che il modello ha già elaborato), Rapid-MLX restituisce la prima parola in 0,08 secondi. Ollama con il vecchio backend? Da 400 a 800 millisecondi. Un rapporto di 5x–10x.
Questi due valori — throughput e TTFT — descrivono due esperienze diverse. Il throughput (tok/s) dice quante parole al secondo il modello genera; il TTFT dice quanto aspetti prima che inizi a rispondere. Entrambi migliorano con Rapid-MLX, ma con magnitudini diverse. Se ti infastidisce il cursore che lampeggia prima che parta la risposta, il TTFT è la metrica che cambia la tua percezione del tutto.
Il caso conservativo: quando il guadagno è più modesto
C’è un dato che non trovi nelle headline ma che vale la pena conoscere. Su un M5 Pro con un modello da 8 miliardi di parametri, la differenza tra MLX e Ollama è di +29%: 62 tok/s contro 48 tok/s (PromptQuorum).
Non è una rivoluzione — è un miglioramento concreto. E questo scenario conservativo vale quando hai un chip meno potente e carichi un modello piccolo, dove il collo di bottiglia è meno marcato.
Il messaggio onesto è: il guadagno esiste, è misurabile, ma va da +29% a +3,2x a seconda di cosa hai e di cosa carichi. Non c’è un numero unico che rappresenti tutti i casi.
Cos’è Rapid-MLX e chi c’è dietro
Prima di dirti come provarlo, una nota di contesto utile.
Rapid-MLX non è un prodotto Apple. È un progetto terzo, open source, licenza Apache 2.0, nato nel marzo 2026 e ora alla versione 0.11.8 (rilasciata proprio il 2 agosto 2026 — sviluppo attivo, rilasci multipli ogni settimana). L’autore è Raullen Chai con il suo team. Il repository ha 3.400 stelle su GitHub e 388 fork.
La relazione con Apple è questa: Apple fa il framework (MLX), Rapid-MLX ci costruisce sopra il motore di inferenza. Come se Apple avesse inventato un motore ad alta efficienza e un team esterno lo avesse montato in una macchina ottimizzata per il tracciato. Il motore è Apple, il setup da corsa è Rapid-MLX.
Come si usa: la GUI per chi non vuole il terminale
Per il pubblico di questo canale — creativi, fotografi, videomaker, designer — la strada giusta è la GUI.
La versione CLI di Rapid-MLX ha un attrito reale: macOS include di default Python 3.9, ma il programma richiede Python 3.10 o superiore. Questo significa aprire il terminale, installare una versione aggiornata di Python, gestire l’ambiente virtuale. Non è impossibile, ma non è immediato per chi non programma abitualmente.
Esiste però Rapid-MLX Desktop, una GUI gratuita. Stando a quanto dichiara il progetto (nessuna recensione indipendente trovata al momento), l’app è firmata e notarizzata Apple, completamente offline dopo il primo download del modello, e non richiede account. Il repository GitHub corrobora l’esistenza dell’app e la descrive come “one-click Mac app”. Essendo una app Mac già pacchettizzata, non dovrebbe chiederti di smanettare con le versioni di Python — ma non l’ho installata di persona, quindi te lo dico con questa cautela.
Requisiti minimi: macOS 14 o successivo, Mac con chip Apple Silicon M1 o successivo, 8GB di RAM (16GB consigliati per modelli più grandi).
Se hai un Mac Intel, Rapid-MLX non è per te.
Il campo si sta muovendo: Ollama insegue
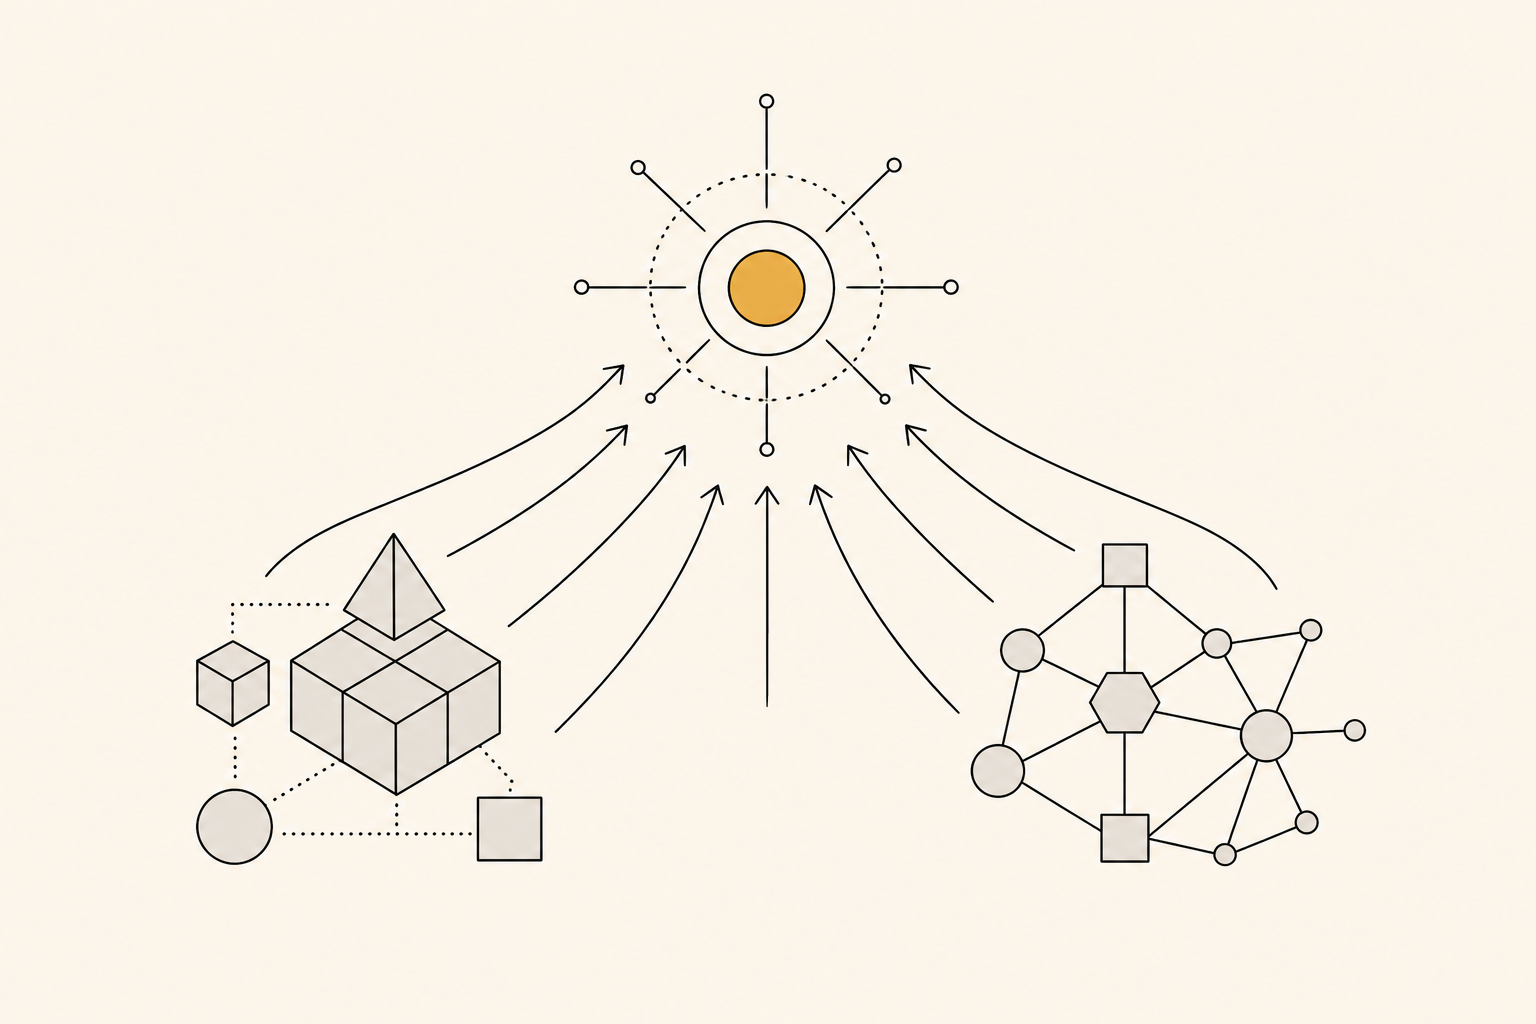
Qui c’è la svolta editoriale più importante del pezzo: il confronto “4,2x vs Ollama” è già parzialmente superato.
Il 30 marzo 2026, Ollama ha annunciato il passaggio a MLX come backend con la preview 0.19 (Ollama Blog). I loro stessi benchmark mostrano questo salto: decode da 58 a 112 tok/s, prefill da 1154 a 1810 tok/s — solo cambiando il backend, sullo stesso hardware. Un +93% sul decode, senza toccare una riga di codice da parte tua.
Attenzione però: è ancora una preview, non stabile per tutti, e i loro numeri usano un modello quantizzato NVFP4 con un confronto interno tra Ollama 0.18 e 0.19 — non un confronto diretto con Rapid-MLX. Non sono mele-con-mele.
Il punto è un altro: il protagonista vero di questa storia non è né Rapid-MLX né Ollama. È MLX, il framework Apple, che sta diventando lo standard di fatto per l’inferenza su Apple Silicon. Tutti si stanno adeguando perché il vantaggio della memoria unificata, sfruttato correttamente, è reale. Chi lo sfrutta prima — come Rapid-MLX sta facendo ora — ne trae vantaggio oggi. Ma tra sei mesi il delta tra i tool si sarà ridotto significativamente.
Il consiglio pratico: provare Rapid-MLX adesso non è “scommettere” su un progetto marginale. È sfruttare un vantaggio reale e temporaneo, sapendo che il resto dell’ecosistema sta convergendo nella stessa direzione.
Come ho raccontato in Ho scaricato un’AI sul mio Mac al Lago di Ledro, l’idea di far girare un modello completamente offline — senza account, senza server, senza dati che escono dalla tua macchina — ha una logica pratica molto concreta per chi lavora con documenti sensibili: contratti, brief di clienti, script, testi proprietari. Quello che cambia con Rapid-MLX è che questa esperienza diventa più fluida e più veloce.
Locale vs cloud: dove il Mac regge e dove no
Con la velocità migliorata, è utile fare il punto su cosa i modelli locali gestiscono bene oggi e cosa no.
Il locale regge bene su task ripetitivi e prevedibili: bozze di testo, sommari di documenti, revisioni leggere, domande su materiale che hai già in locale, code review su porzioni di codice. Il TTFT di 0,08s su prompt cached significa che se hai un workflow che ripete certi task, la risposta arriva quasi in tempo reale.
Dove il cloud mantiene un vantaggio netto: ragionamento multi-step complesso, task che richiedono il modello più capace disponibile, multimodalità avanzata (immagini in input, voce), web search integrata. Nessun modello locale che gira su un Mac è oggi equivalente a GPT-5 o Claude 4 per il lavoro di ragionamento profondo.
La strategia che ha senso per un creativo è ibrida: locale per i task ripetitivi, confidenziali, o quando sei offline; cloud per il ragionamento frontier. Non è o/o.
Ne avevo parlato in termini più ampi discutendo di quanto il costo dell’AI stia cambiando: il locale è, tra le altre cose, una risposta al problema dei costi variabili del cloud. Se lo usi per i task giusti, non devi scegliere tra velocità e portafoglio.
Cosa fai adesso
Ricapitolo in tre punti quello che vale tenere.
Primo: il tuo Mac M era già buono per l’inferenza locale — era il software a non sfruttarlo. Rapid-MLX cambia questo, usando il framework nativo Apple anziché llama.cpp.
Secondo: i guadagni reali sono 1,3x–3,2x di throughput (tok/s) a seconda del modello che carichi — non del solo chip che hai. Il TTFT su prompt cached è il dato più impressionante: da 400-800ms di Ollama a 0,08s. Tienili distinti quando valuti se ti interessa.
Terzo: se hai un Mac M1 o successivo con macOS 14, puoi scaricare Rapid-MLX Desktop (gratuito, stando a quanto dichiara il progetto offline e senza account) e provare oggi senza toccare il terminale. Se hai un Mac Intel, non è compatibile.
Il campo si sta muovendo velocemente: Ollama 0.19 sta già migrando verso MLX, il gap si ridurrà. Ma adesso il vantaggio esiste, è misurabile, e non richiede di comprare niente.
L’hardware che hai sulla scrivania era già più capace di quanto pensassi. Solo che nessuno gliel’aveva detto nel modo giusto.
Articoli correlati
- Ho scaricato un’AI sul mio Mac al Lago di Ledro. Ecco perché dovresti farlo anche tu.
- L’AI di Apple è arrivata. In Italia, quasi.
- Pagheremo l’AI a consumo? Sì, no e dipende da chi sei
- Stiamo installando un nuovo sistema operativo. E non lo sappiamo.
Fonti
- Rapid-MLX — Repository GitHub ufficiale (raullenchai)
- PyPI rapid-mlx — pagina pacchetto, versione 0.11.1 del 28 luglio 2026
- GitHub Releases raullenchai/Rapid-MLX — changelog versioni
- ml-explore/mlx — Framework MLX di Apple
- Ollama Blog: MLX on Apple Silicon (preview 0.19, 30 marzo 2026)
- andrew.ooo: Rapid-MLX Review — benchmark indipendenti con metodologia esplicita (13 maggio 2026)
- PromptQuorum: MLX vs Ollama vs llama.cpp su Mac
- Rapid-MLX Desktop — sito ufficiale
✍️ Articolo firmato da “La Redazione”: sistema editoriale multi-agente (AI) orchestrato con Claude Code e supervisionato da Luca Cazzaniga · lucacazzaniga.it
Leggi anche


