 12 min di lettura
Nelle Tue Automazioni Paghi uno Scrittore per Fare il Centralinista
Riepilogo Articolo - Luca Cazzaniga
Jev, il primo modello di TypeSafe AI, decide senza scrivere una parola: più veloce e più economico, dice chi lo vende. Ma su quanto decida bene, nessuno ha ancora misurato niente.
📌 Jev è il primo modello di una startup uscita dallo stealth a metà settembre 2026: invece di scrivere testo come un LLM classico, restituisce direttamente una decisione strutturata (un sì/no, un’etichetta, un punteggio). In questo pezzo vediamo cos’è, cosa promette chi lo vende e, soprattutto, cosa manca ancora prima di potersene fidare: una misura indipendente di quanto decida bene, non solo di quanto sia veloce.
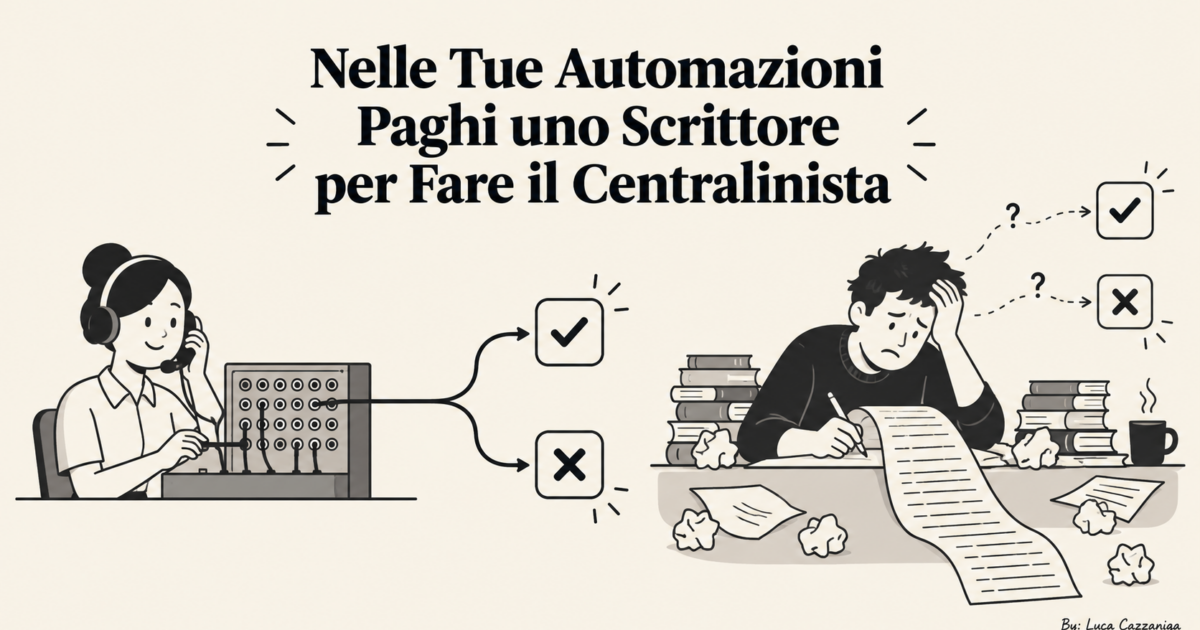
Il centralinista che ti risponde al telefono non fa conversazione. Ascolta due parole, “prenotazioni” o “assistenza”, e ti gira al reparto giusto. Non ha bisogno di saper scrivere un tema per farlo: deve solo scegliere, in fretta, tra un numero limitato di opzioni.
Adesso guarda una tua automazione (un flusso su n8n, una catena di prompt, un agente che smista le email in arrivo). Quante delle sue decisioni assomigliano a quella del centralinista, una scelta secca tra due o tre strade, e quante volte invece di lasciargliela fare in un istante gli fai scrivere un piccolo saggio per arrivarci?
Quante decisioni travestite da testo ci sono nelle tue automazioni
Molti dei passaggi che oggi deleghiamo a un modello di linguaggio generalista (smistare una richiesta in arrivo, taggare un contenuto, decidere quale ramo di un flusso attivare) non producono testo libero. Producono una scelta tra un numero limitato di opzioni. Trattarli come compiti di scrittura è, ragionevolmente, una delle cause di lentezza e costo nelle automazioni che costruiamo. Non “la” causa, attenzione: nessuna fonte misura quanta parte del costo totale di un’automazione dipenda proprio da questo effetto specifico. È un ragionamento che ti propongo, non un dato che ho trovato scritto da qualche parte.
Un ragionamento che però regge: il divario dichiarato tra un modello pensato apposta per decidere e un LLM generalista, su singole chiamate, è enorme e, almeno sulla velocità, una misura indipendente lo conferma (lo vedi tra poco nei numeri).
Te lo dico subito per onestà, prima ancora di raccontarti cos’è Jev: il ponte diretto verso gli strumenti che usi tutti i giorni (n8n, Zapier) oggi è debolissimo. Questa non è la storia di uno strumento pronto da installare stasera. È la storia di un principio architetturale che vale la pena capire, a prescindere da quale vendor te lo porterà davvero a portata di mano. Ci torno alla fine.
Cos’è Jev, in parole semplici
Jev è il primo modello rilasciato da TypeSafe AI, una startup uscita dallo stealth a metà settembre 2026. A differenza di un LLM che scrive testo parola per parola, Jev restituisce direttamente una decisione strutturata: un formato fisso, non una frase libera (TypeSafe AI blog, SiliconANGLE, Spring blog).
TypeSafe chiama questa famiglia di modelli “System One models”, un nome preso di peso da Daniel Kahneman e dal suo “Pensieri lenti e veloci”: il Sistema 1 è il pensiero veloce e intuitivo (quello che ti fa scartare la mano da una pentola calda senza doverci ragionare), mentre il Sistema 2 è quello lento e deliberato, quello che usi per fare un calcolo complesso. Jev fa la parte del Sistema 1: la scelta rapida, da affiancare a un LLM che fa la parte lenta, non da sostituirlo (TypeSafe AI blog).
Sotto il cofano (lo dice il produttore, nessuna fonte indipendente l’ha verificato) Jev userebbe un “parallel sampler” non autoregressivo. Tradotto: un LLM classico costruisce la risposta un pezzo alla volta, come se scrivesse una frase parola dopo parola, ognuna condizionata dalla precedente. Jev, secondo TypeSafe, genera tutte le risposte possibili in un colpo solo, più come chi guarda un menu e indica subito il piatto invece di descriverlo ingrediente per ingrediente (TypeSafe AI blog; lo stesso concetto lo riprende eesel AI, “one parallel pass”).
Su uno stesso “stato” (diciamo, un ticket di assistenza appena arrivato) puoi fargli tre tipi di domande diverse nella stessa chiamata: un Noul (sì/no, o un valore tra 0 e 1: sì, si scrive proprio così, non è un refuso; più è vicino a 1, più è un sì), un Choice (un’etichetta tra più opzioni, con una probabilità e un grado di confidenza per ciascuna) o uno Score (un valore su una scala ordinata, con un grado di confidenza) (Spring blog, repo GitHub del nodo n8n).
Oggi Jev è in early access, con lista d’attesa per sviluppatori. Sul supporto alla lingua italiana le fonti non dicono nulla: non è né confermato né escluso, semplicemente non se ne parla (TypeSafe AI blog, SiliconANGLE).
Perché non è “solo JSON con un altro nome”
Se lavori anche solo un po’ con l’AI, probabilmente hai già pensato: “ma questo lo fa già da tempo qualsiasi LLM con lo structured output”. Hai ragione ad averlo pensato. OpenAI ha i suoi Structured Outputs, Gemini ha una funzione equivalente, esistono librerie come Instructor, Outlines o BAML che costringono un modello generalista a rispondere dentro uno schema fisso, e prima ancora esistevano i classificatori addestrati ad hoc (eesel AI).
Secondo TypeSafe, la differenza di Jev non è “restituire una scelta invece di un testo”: quello lo sanno già fare in tanti. È l’essere costruito da zero come architettura non autoregressiva: tutte le risposte in un solo passaggio parallelo, invece di prendere un LLM classico e costringerlo dentro uno schema token dopo token (TypeSafe AI blog). Anche eesel (un’azienda che vende automazioni concorrenti, con un interesse dichiarato) arriva alla stessa conclusione tecnica (eesel AI). Ma resta un “secondo TypeSafe” e un “secondo l’analisi di eesel”, non un fatto accertato in modo neutro: nessuna fonte indipendente e senza interessi in gioco lo conferma.
Non è, insomma, la prima volta al mondo che un sistema AI restituisce una scelta invece di un testo libero. È, per come la descrivono le fonti disponibili, una novità di grado tecnico (un modo diverso di arrivarci), non una categoria nuova di prodotto.
I numeri, con il nome di chi li dice
Qui la regola che seguo è semplice: ogni cifra si porta dietro chi l’ha detta. Se leggi “Jev costa X” senza sapere se lo dice TypeSafe o un test indipendente, quella cifra non vale niente.
Il prezzo di listino dichiarato da TypeSafe è 0,042 dollari per milione di token in input; l’output è descritto come “troppo economico da misurare”, di fatto gratuito (TypeSafe AI blog, homepage TypeSafe, MarkTechPost). La latenza dichiarata, sempre dal produttore, va dai 70 ai 500 millisecondi end-to-end (TypeSafe AI blog).
L’unica misura non fatta dal venditore che risulta è quella dell’ingegnere Christian Tzolov di Spring, che ha misurato circa 275 millisecondi con una domanda e circa 310 con tre domande nella stessa chiamata: “circa 300 millisecondi”, scrive lui (Spring blog). È un dato che vale la pena notare proprio perché è l’eccezione indipendente: riguarda però solo la velocità, non se le risposte di Jev sono giuste. Su questo torno tra poco.
Sui moltiplicatori di velocità e risparmio le fonti raccontano storie diverse a seconda del canale. Il blog di TypeSafe parla di “40-200 volte più veloce” (TypeSafe AI blog). L’homepage sale a “193,6 volte più veloce, 444,6 volte più economico” su workflow interni (homepage TypeSafe, MarkTechPost). Lo stesso tipo di benchmark, ripreso da Spring, diventa “10-125 volte più veloce e 22-805 volte più economico” rispetto a Claude Haiku e ai modelli di ragionamento (Spring blog). Un post del fondatore ripreso dalla stampa parla ancora di “20-200 volte” e “40-400 volte più economico”, sotto i 100 millisecondi (SiliconANGLE, Tech Startups). Sono numeri dello stesso venditore che non tornano tra loro da un canale all’altro: un motivo in più per non citarli mai come “il dato di TypeSafe” al singolare, ma sempre con la fonte precisa.
Un confronto d’obbligo, per darti un metro reale: Claude Haiku 4.5 di Anthropic (un LLM piccolo e già pensato per compiti veloci) costa 1 dollaro per milione di token in input e 5 in output, secondo il listino ufficiale; Anthropic non pubblica una latenza in millisecondi (Anthropic). Attenzione però: le unità non sono del tutto omogenee, perché i benchmark di TypeSafe sono spesso “per chiamata” su workflow interni, non “per milione di token” come il listino Anthropic. Per questo non puoi prendere i due numeri e dividerli per dire “Jev costa X volte meno di Claude”: servirebbe lo stesso metro per entrambi, e qui non c’è. E Haiku, va detto, non è per forza il modello economico più conveniente sul mercato oggi: un secondo confronto, con un Gemini Flash o un modello “mini” di OpenAI, completerebbe il quadro. Prendilo quindi come un metro indicativo, non come il termine di paragone definitivo.
Ultima cosa, e non secondaria: i benchmark principali sono condotti dallo stesso TypeSafe, su workflow scritti dal suo team. Lo segnala esplicitamente anche MarkTechPost, con un consiglio pratico: “test on your own data” (MarkTechPost). Come nota MarkTechPost, TypeSafe non può dimostrare che il prezzo comunicato non sia sussidiato, cioè tenuto artificialmente basso per far crescere l’adozione (MarkTechPost).
Il buco più grande: nessuno sa ancora se decide bene
Arriviamo al punto che conta più di ogni moltiplicatore. TypeSafe dichiara alcuni limiti con onestà: Jev non genera testo libero, gestisce al massimo 255 opzioni tra cui scegliere, e per ora non lavora con le immagini (TypeSafe AI blog). Sono confini utili, perché ti dicono subito dove Jev non va usato: non è un sostituto generale di un LLM, è uno strumento per un tipo preciso di compito.
C’è poi un claim del venditore da prendere con le pinze: TypeSafe dice che Jev “non può allucinare” (TypeSafe AI blog). È vero solo in un senso stretto: il modello garantisce che l’output rispetti lo schema che gli hai dato, se gli chiedi “sì o no” risponderà sempre “sì” o “no”, mai una frase fuori formato. Non garantisce che quella risposta sia quella giusta. Un modello può restare sicurissimo di sé e sbagliare comunque: lo dice eesel, quasi testualmente, “può restare sicuro di sé e comunque sbagliato” (eesel AI, eesel AI); anche MarkTechPost e SiliconANGLE ridimensionano lo stesso “non può allucinare”, pur senza usare le stesse parole (MarkTechPost, SiliconANGLE). E va detto per completezza: Jev non ha pesi aperti né si può ospitare sui tuoi server, si usa solo come servizio in cloud di TypeSafe (MarkTechPost).
Ed ecco il punto centrale, quello che nessun titolo entusiasta ti dirà: nessuna fonte tra quelle verificate misura in modo indipendente quanto bene Jev decida. Non la sua accuratezza, non il suo tasso di errore, confrontato con un LLM classico o con un classificatore addestrato apposta. L’unica misura di terze parti che esiste riguarda la velocità, quella di Tzolov vista sopra, non la qualità delle decisioni.
Tra le fonti raccolte c’era anche un trial di eesel su 284 conversazioni che a prima vista sembrava la prova che mancava. Leggendo bene il testo originale, però, quel trial riguarda il sistema di eesel, non Jev: l’ho scartato apposta, perché usarlo come prova su Jev sarebbe scorretto.
Quindi, oggi, sappiamo (secondo il venditore) che Jev è veloce ed economico. Non sappiamo quanto sia accurato rispetto alle alternative. E un modello che decide in 300 millisecondi ma sbaglia più spesso di un LLM più lento non è un risparmio: è un rischio spostato più a valle, dove magari te ne accorgi solo quando il cliente sbagliato è già stato smistato al reparto sbagliato.
Chi c’è dietro (in breve, perché non è il cuore della storia)
TypeSafe AI è stata fondata da Diogo Almeida (CEO), Erik Gafni e Sasha Sheng (Wilson Sonsini, SiliconANGLE, Tech Startups). Almeida è un ex ricercatore OpenAI che ha lavorato su RLHF, InstructGPT, ChatGPT e GPT-4 (SiliconANGLE): preferisco questa formula a “co-inventore di ChatGPT”, l’etichetta usata dallo studio legale dell’operazione in un comunicato con un interesse promozionale dichiarato (Wilson Sonsini).
TypeSafe è uscita dallo stealth a metà settembre 2026 con un round seed da 40 milioni di dollari guidato da DCVC (Wilson Sonsini). Lo cito solo come contesto: non è, e non deve diventare, l’argomento per cui Jev funziona o no.
Il ponte per chi non scrive codice non c’è ancora
Ora la domanda che probabilmente ti stai facendo se lavori con n8n o Zapier invece che con Python: posso usarlo oggi nel mio flusso? La risposta onesta è no, non ancora in modo serio.
Esiste un solo nodo community per usare Jev dentro n8n. È dichiaratamente “non affiliato, non supportato da TypeSafe”, ha 2 stelle e 1 fork su GitHub: un’adozione, insomma, vicina a zero (repo GitHub). Nessuna integrazione ufficiale con Zapier o Make risulta dalle fonti controllate.
Quindi la lezione pratica non è “vai a installare Jev oggi”, visto che quello strumento specifico non è ancora alla portata di chi non programma: è guardare i passaggi delle tue automazioni e chiederti quali sono davvero decisioni travestite da compiti di scrittura.
Cosa portare a casa
La domanda operativa da farti su ogni passaggio delle tue automazioni è una sola: sto facendo scrivere un modello quando basterebbe fargli scegliere? Se la risposta è sì, controlla se quel passaggio può già oggi appoggiarsi a uno strumento che restituisce una scelta invece di un testo libero: gli Structured Outputs di OpenAI, l’equivalente di Gemini, un classificatore addestrato su misura. Non condividono il vantaggio specifico di velocità e costo che le fonti attribuiscono a Jev (quello, secondo loro, deriva proprio dal non essere autoregressivo), ma sono qui, oggi, e li puoi testare senza aspettare nessuna lista d’attesa.
In futuro, un modello dedicato come Jev potrà diventare l’opzione giusta per certi step. Ma prima di consigliarti di cambiare architettura a un’automazione che funziona, voglio vedere una misura indipendente di quanto decide bene, non solo di quanto è rapido. Per ora la lezione non è correre a integrare un venditore giovane ancora in accesso anticipato: è smettere di dare per scontato che un modello bravo a scrivere sia automaticamente lo strumento giusto per fare il centralinista.
Se gestisci automazioni (n8n, Zapier, o una tua catena di prompt fatta in casa), la prossima volta che apri quel flusso prova questo esercizio: segna ogni nodo che oggi chiede a un LLM di “scrivere” qualcosa, e chiediti se in realtà gli stai solo chiedendo di scegliere. Se ne trovi anche solo due o tre, hai già trovato un risparmio più concreto di qualsiasi moltiplicatore letto in questo pezzo.
Articoli correlati
- Perché il Loop Engineering “è una cagata pazzesca”
- N8N: La Guida per iniziare ad Automatizzare il Tuo Lavoro
- Agenti AI: cosa sono, che tipi esistono, dove usarli
- Pagheremo l’AI a consumo? Sì, no e dipende da chi sei
Fonti
- TypeSafe AI blog, “Introducing System One Models & Jev” (annunciato 15/09/2026)
- Homepage TypeSafe AI (consultata 26/09/2026)
- Spring blog, Christian Tzolov, “Spring AI and TypeSafe Jev: Fast, Cheap, Structured Decisions” (21/09/2026)
- MarkTechPost, Asif Razzaq (19/09/2026)
- SiliconANGLE, Paul Gillin (16/09/2026)
- Tech Startups, Daniel Levi (16/09/2026)
- Wilson Sonsini, comunicato sul round seed (15/09/2026)
- eesel AI, “TypeSafe Jev review”, Rama Adi Nugraha (agg. 21/09/2026)
- eesel AI, “TypeSafe Jev alternatives”, Alicia Kirana Utomo (agg. 21/09/2026)
- Anthropic, “Introducing Claude Haiku 4.5” (15/10/2025)
- GitHub, n3ndor/n8n-nodes-typesafe-jev
✍️ Articolo firmato da “La Redazione”: sistema editoriale multi-agente (AI) orchestrato con Claude Code e supervisionato da Luca Cazzaniga · lucacazzaniga.it
Leggi anche