 14 min di lettura
Cento modifiche sulla stessa faccia: chi le ha verificate?
Seedream 5.5 promette immagini AI con memoria. Per ora è una demo del produttore, non una misura: ecco il test da fare tu.
📌 Il 9 novembre ByteDance ha annunciato Seedream 5.5, un generatore di immagini che promette modifiche ripetute senza spostare i colori e soggetti con sfondo trasparente già pronti. Questo pezzo non ti dice “provalo”: ti dice come lo provi, e come leggere un comunicato stampa senza farti incantare. Alla fine trovi un test da fare lunedì mattina, valido per qualunque modello.
Hai presente la fotocopia della fotocopia?
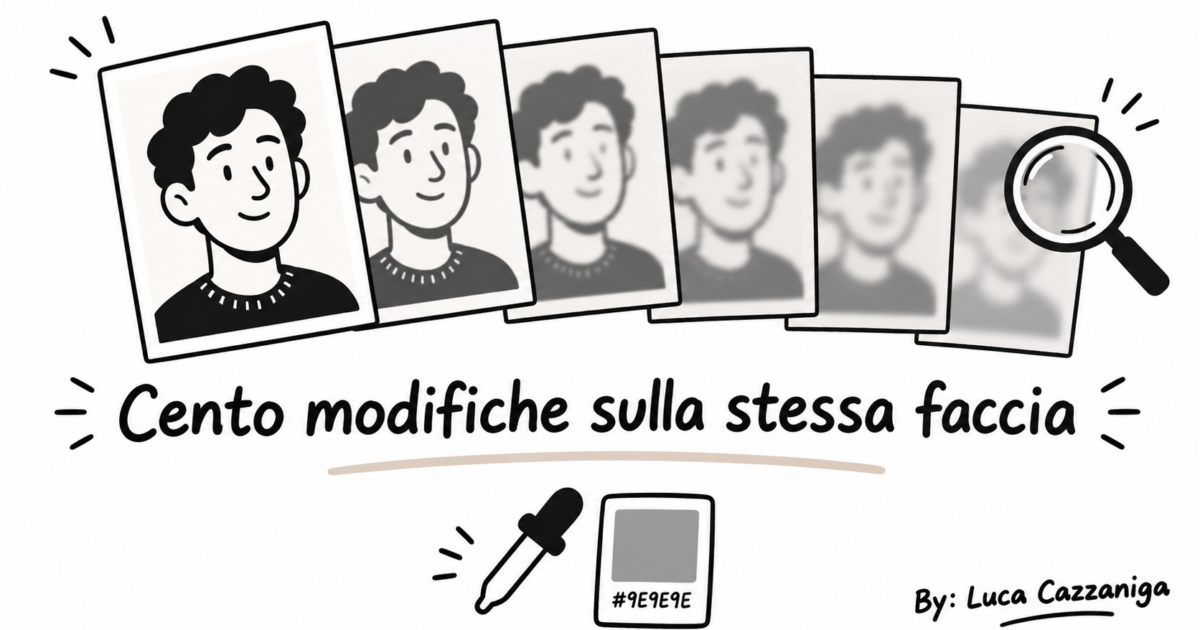
Fai una copia di un documento, poi una copia della copia, poi una copia di quella. Alla terza non noti niente. Alla decima il nero è diventato grigio, i bordi sono sporchi e la pelle di una foto ha preso un colore che non era il suo. Nessuna singola copia era un disastro. Il disastro è la catena.
Con le immagini AI succede la stessa cosa, e chi lavora con le foto lo sa bene. Chiedi una modifica, va bene. Ne chiedi una seconda partendo dal risultato della prima, va ancora bene. Alla quinta, alla sesta, qualcosa si è mosso: la camicia non è più così bianca, il volto sembra di una persona leggermente diversa, l’anello è diventato una macchia.
Il 9 novembre ByteDance ha detto di aver fatto cento passaggi di fila sulla stessa persona, e che quello che non toccava è rimasto com’era, colori compresi. Cento. Chi l’ha verificato? Solo ByteDance, e senza pubblicare un numero. Il comunicato è sul blog ufficiale del suo team di ricerca, datato 9 novembre 2026.
Vediamo cosa c’è davvero dentro quell’annuncio, cosa no, e cosa puoi fare tu.
Riepilogo Articolo - Luca Cazzaniga
Il problema vero: l’immagine AI era una stampa, non un file
Quando lavori su un RAW o su un PSD, ogni modifica è reversibile e il resto dell’immagine resta dov’è. Se togli una macchia dalla camicia, la pelle non si sposta di un millimetro. Questa è la differenza tra un file di lavoro e una stampa: sul file puoi tornare indietro, sulla stampa no.
Le immagini generate dall’AI, finora, si sono comportate più come stampe. Ogni volta che chiedi una modifica, il modello non sposta solo il pezzo che gli hai indicato: spesso ricostruisce l’intera immagine e, ricostruendola, la reinterpreta. Piccole differenze invisibili al primo giro, che si sommano. È la fotocopia della fotocopia.
Non è un’impressione mia e non è un difetto di un singolo prodotto. Ne avevo già parlato in Perché le tue immagini AI peggiorano ad ogni modifica (e come evitarlo), e la ricerca accademica del 2026 la descrive allo stesso modo: la perdita di identità del soggetto e l’accumulo di errori nell’editing a più turni sono un limite riconosciuto dei modelli attuali. Lo dice, per esempio, AnchorEdit, un preprint (uno studio non ancora passato dalla revisione di altri ricercatori) pubblicato a giugno 2026, che parte proprio da questa premessa.
Attenzione a come uso quella fonte: AnchorEdit è un lavoro di ricerca con i risultati dei suoi stessi autori. Mi serve per dirti che il problema esiste ed è riconosciuto, non per dirti quanto pesa su un modello preciso.
Perché ti interessa? Perché il vero collo di bottiglia, per chi lavora con le immagini, non è la risoluzione né il realismo. È poter modificare senza degradare. Un generatore che sbaglia la prima volta lo rifai. Un generatore che peggiora ad ogni ritocco non entra in un flusso di lavoro, per quanto bello sia il primo risultato.
Cosa ha davvero annunciato ByteDance (e cosa no)
Leggiamo l’annuncio con calma, perché la differenza sta nei dettagli.
Cosa dice ByteDance. Seedream 5.5 è stato addestrato, secondo ByteDance, per preservare a livello di pixel le zone che non vuoi toccare ed eliminare gli spostamenti di colore in quelle aree. Per mostrarlo, il team ha fatto una dimostrazione: la stessa immagine di una persona, modificata 100 volte di seguito, ogni volta partendo dal risultato precedente. Si cambiano abiti, oggetti, piccoli dettagli come gli anelli.
Cosa è, in realtà. Una demo. Un esempio scelto da chi ha costruito il modello, su un ritratto. Non è un limite tecnico del tipo “il modello arriva fino a 100 e poi si ferma”, e non è nemmeno una capacità garantita su qualunque foto.
Le testate che hanno rilanciato la notizia la leggono in modo diverso, e la differenza conta. The Decoder (9 novembre) attribuisce tutto a ByteDance e lo definisce non verificato, ma nel titolo e nel testo presenta i 100 round come una capacità del modello. The Next Web (stessa data) è più cauto nel corpo dell’articolo: chiama quei 100 passaggi una singola demo e precisa che i dati sulle prestazioni sono quelli dichiarati da ByteDance stessa.
Io mi fido della seconda lettura, perché è quella che coincide con il testo originale del produttore.
E la misura? Qui sta il punto che regge tutto il resto: ByteDance non pubblica nessuna metrica numerica della deriva di colore. Non c’è un numero che dica “dopo 100 passaggi il bianco è cambiato di tanto” oppure “l’incarnato è rimasto entro tot”. C’è una dichiarazione (“senza spostamenti di colore”) e c’è una demo. Una dichiarazione non è una misura. Una demo non è un campione.
E non c’è, al momento in cui scrivo (10 novembre), nessun test indipendente di Seedream 5.5: nessuna recensione sul campo, nessuno che l’abbia messo sotto torchio. Le ricerche che ho fatto restituiscono solo pagine pre-lancio o marketing.
Non sto dicendo che ByteDance menta. Sto dicendo che la frase “regge 100 modifiche” oggi non ha nessuno che l’abbia controllata a parte chi la pronuncia.
I numeri che ci sono parlano d’altro
Nell’annuncio ci sono molti numeri, ed è facile confonderli con la prova di stabilità. Mettiamoli in fila, perché nessuno di loro misura la deriva.
Le valutazioni sono state fatte da ByteDance su una sua piattaforma interna, MagicArena, su sei scenari (e-commerce, marketing, film e TV, videogiochi, ufficio, design di moda), confrontando Seedream 5.5 con la propria versione precedente. Due misure: il tasso di usabilità (quante immagini sono “utilizzabili”) e un punteggio medio di giudizio dei valutatori.
Cosa dicono, sempre secondo ByteDance:
- In film e TV e nella produttività d’ufficio, il tasso di usabilità è più del doppio rispetto alla versione precedente.
- Nei test GSB (Good, Same, Bad: i valutatori guardano due immagini e dicono quale preferiscono, o se sono pari), il realismo nelle modifiche da immagine a immagine cresce del 55,62%.
- La corruzione grave del testo dentro le immagini scende allo 0,4%, quella lieve all’1,7%. The Next Web precisa che sono percentuali sulle sue immagini di test.
Ora, come si legge quel 55,62%. Non vuol dire “immagini realistiche al 55% in più”. Vuol dire che, nei confronti a coppie fatti dai valutatori del produttore, il saldo tra “preferisco la nuova” e “preferisco la vecchia” è andato in quella direzione. È una misura di preferenza, non di quanto le immagini siano vere.
E soprattutto: tutti questi numeri riguardano qualità e testo. Nessuno riguarda la stabilità nel tempo. Sono il voto che la scuola dà ai propri studenti, non la verifica fatta da un esaminatore esterno.
ByteDance cita anche due concorrenti, GPT Image 2.5 Sunburst e Nano Banana 2.1, ma solo su realismo e testo, senza i numeri assoluti degli altri. Sulla stabilità nelle modifiche ripetute, per nessun modello, ByteDance o concorrente, esistono dati pubblici confrontabili. Quindi non c’è un “5.5 batte gli altri” da raccontare. Se qualcuno te lo scrive, chiedigli dove sta il numero.
Il secondo pezzo: il soggetto come adesivo staccabile
Fin qui la memoria. L’altra novità è più concreta per chi fa grafica, e-commerce, locandine.
Seedream 5.5, dichiara ByteDance, genera direttamente immagini con canale alfa, anche con trasparenza piena e parziale. Tradotto: l’alfa è la “quarta informazione” di ogni pixel, oltre al rosso, al verde e al blu. Dice quanto quel punto è trasparente. È ciò che fa sì che un’immagine possa stare su uno sfondo qualunque senza il rettangolo bianco intorno.
Pensa alla differenza tra un poster e un adesivo. Con il poster, se vuoi tenere solo il soggetto, devi ritagliarlo con le forbici (cioè con la rimozione dello sfondo, i tracciati, le maschere). Con l’adesivo, il soggetto nasce già staccabile: lo applichi dove ti serve. Se il modello fa davvero questo, sparisce uno dei passaggi più noiosi del lavoro di impaginazione.
Due cautele. La prima: che il canale alfa sia “nativo” è una dichiarazione del produttore, ripresa da The Decoder e The Next Web, ma nessuno l’ha provata fuori da ByteDance. La seconda: non c’è alcuna informazione su cose che un professionista chiederebbe subito, come la risoluzione massima, i formati di output, la profondità colore o se si può lavorare con maschere per modificare solo una parte. Nelle fonti che ho letto non ci sono. Quindi non lo scrivo, e non dovresti nemmeno immaginarlo: l’unica cosa dichiarata è che l’immagine esce con la trasparenza.
Capelli, fumo, vetro, ombre morbide: è lì che un ritaglio automatico di solito si tradisce. Quando potrai provarlo, è proprio lì che dovrai guardare. Lo metto nel protocollo più sotto.
Perché “100” non si confronta con niente
Un’ultima osservazione sui cento passaggi: sono un numero che nessun altro misura.
Nei benchmark che ho consultato (i banchi di prova su cui si misurano i modelli), gli ordini di grandezza sono molto più bassi. AnchorEdit parla di oltre 10 turni di interazione. EdiVal, un altro benchmark, misura fino al terzo turno. Esistono anche benchmark pensati proprio per le modifiche a più turni, come I2EBench2.0 (arXiv, giugno 2026, accettato alla rivista IJCV), che misura coerenza e precisione su più dimensioni. Dal riassunto iniziale dello studio non si ricava però quanti turni arrivino a testare, quindi lo cito solo per dirti che il campo esiste.
Il punto è questo: nei benchmark consultati, nessuno si avvicina a 100. Cento è un ordine di grandezza sopra. Perciò non ci sono termini di confronto indipendenti per il dato di ByteDance, e finché nessuno ripete l’esperimento, quel numero resta una promessa.
Non è una critica: è solo che per verificarlo serve qualcuno che lo faccia. Qualcuno come te.
Dove lo usi, quanto costa: quasi niente di certo
Se stai pensando “bene, lo provo adesso”, fermati un attimo, perché le informazioni pratiche sono scarse.
Dove. Secondo ByteDance, come riportano The Decoder e The Next Web, il rilascio è graduale su Jimeng, Doubao, Doubao Work e Volcengine Ark: app e piattaforme cloud del mondo cinese. Attenzione alla formula: la pagina inglese del comunicato non elenca le piattaforme, che arrivano dalle testate che l’hanno rilanciato.
Pro. È stata annunciata anche una versione Pro, senza data.
Prezzo. Nessuno ha pubblicato un prezzo per Seedream 5.5.
Dall’Europa e uso commerciale. Qui voglio essere preciso: accesso dall’Europa e licenza commerciale delle immagini generate non sono documentati nelle fonti aperte che ho potuto consultare al 10 novembre. Non sto dicendo che non si possa usare né che sia vietato. Sto dicendo che non c’è scritto da nessuna parte, e prima di metterlo in un lavoro per un cliente dovrai leggere i termini d’uso quando saranno disponibili.
Solo per contesto, e riferito alla versione precedente (la 5.0), non alla 5.5: la pagina ufficiale Dreamina del 22 ottobre elencava per Seedream 5.0 canali come Dreamina, BytePlus ModelArk, fal e, per la sola versione Lite, Replicate, e precisava che l’abbonamento a Dreamina non include l’accesso per gli sviluppatori (l’API). Se un giorno la 5.5 seguirà la stessa strada lo sapremo da ByteDance, non da me.
Quindi: oggi questo pezzo non è una recensione e non può esserlo. È la ragione per cui conta di più la parte che segue.
Il protocollo di deriva: dieci minuti, per qualunque modello
Cosa fai quando esce un modello che promette stabilità? Non ti fidi e non lo scarti: lo metti alla prova sul tuo file. Questo è un metodo che ho messo giù io, non un dato di fonte: nessuna soglia, nessun risultato atteso.
Il tempo dipende da quanti passaggi fai e da quanto è veloce il modello. Per una catena corta, calcola una decina di minuti: è un ordine di grandezza, non una promessa.
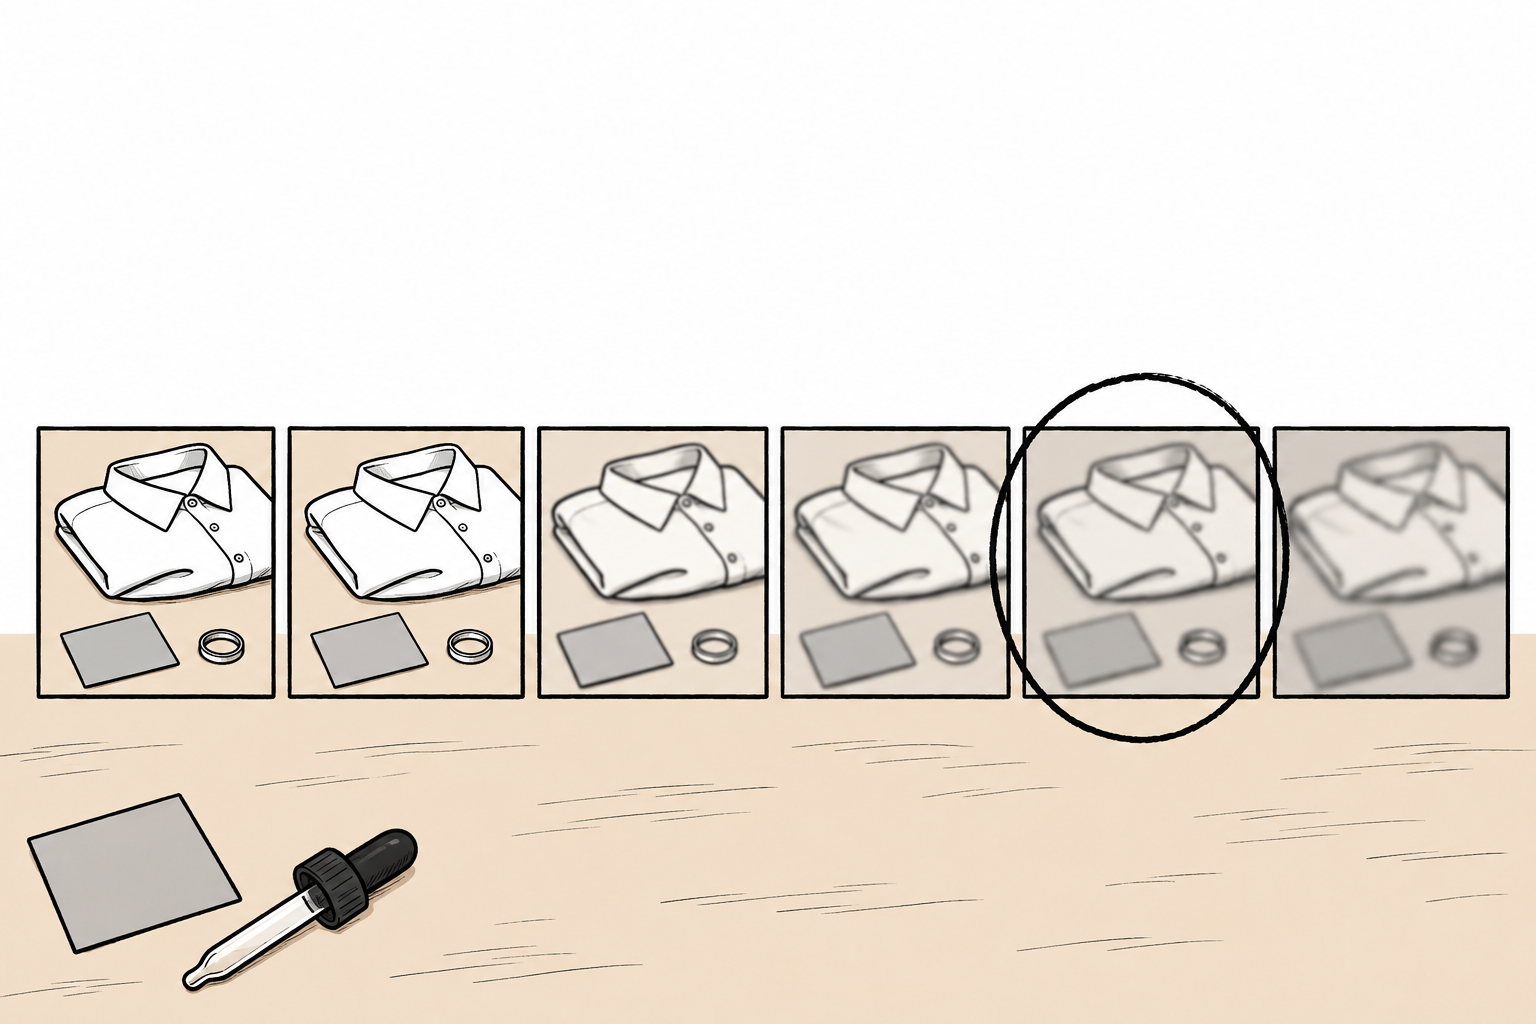
Prima di cominciare, prepara l’immagine di partenza. Serve una foto con questi tre elementi:
- Una pelle in luce nota: un ritratto che conosci, con una luce che sai com’era.
- Un bianco di riferimento: una camicia bianca, un muro, un foglio di carta grigia. Qualcosa che nella realtà non cambia.
- Un dettaglio piccolo: un anello, una scritta, un bottone. Le cose piccole sono le prime a sfaldarsi.
Poi, la catena. Fai una serie di modifiche scollegate tra loro: cambia un oggetto sul tavolo, cambia il colore di un abito, aggiungi un paio di occhiali. Ogni volta parti dal risultato del passaggio precedente, non dall’originale. È esattamente quello che ha fatto ByteDance nella sua demo, solo che qui decidi tu le modifiche e la foto.
A ogni passaggio, controlla quattro cose, affiancando il risultato all’originale:
- Incarnato. La pelle ha lo stesso colore e la stessa luce? Il volto sembra ancora la stessa persona?
- Bianco di riferimento. Qui metti un numero. Prendi il campionatore (il contagocce di Photoshop o di Lightroom), leggi i valori del bianco di riferimento nell’originale e rileggili a ogni passaggio, scrivendoli in una tabella. È il pezzetto che ti evita l’obiezione “anche tu stai solo guardando a occhio”: su quel punto hai un numero, come la bilancia in cucina.
- Dettagli piccoli. L’anello è ancora un anello? La scritta si legge?
- Bordi dell’alfa, se il modello li produce. Capelli, bordi sfumati, parti semitrasparenti: ingrandisci al 200% e guarda se c’è un alone, un bordo seghettato, un ritaglio brusco.
Segna il passaggio in cui la differenza diventa visibile a occhio. Non deve essere il passaggio in cui il file è “rovinato”: è quello in cui, mostrandolo a un collega senza dirgli niente, lui direbbe “qui è cambiato qualcosa”. Quel numero è il tuo risultato: i passaggi utili, non la promessa.
Per essere onesto, fai lo stesso test con due modelli, sulla stessa foto e con le stesse modifiche. Un risultato isolato non dice niente: serve il confronto. E se hai già un modello che usi tutti i giorni, quello è il tuo termine di paragone naturale.
Una nota sui limiti del metodo. Con una sola foto e una sola catena, non puoi dire “questo modello è stabile”. Puoi dire “su questa foto, con queste modifiche, ho notato il cambiamento al passaggio tale”. Per un fotografo che sceglie lo strumento per il proprio lavoro è già moltissimo: è un dato tuo, su materiale tuo.
Cosa porti a casa
Tre cose.
1. Il vocabolario per leggere un comunicato. Ogni volta che leggi di un nuovo modello, chiediti:
- È una demo o una capacità? Una demo è un esempio scelto da chi l’ha costruito, una capacità è qualcosa che funziona su qualunque foto.
- È un test interno o indipendente? Se a misurare è chi vende, il numero è una dichiarazione.
- È una dichiarazione o una metrica? “Senza spostamenti di colore” è una frase. “Il bianco è passato da 245 a 243” (numeri d’esempio, inventati per spiegarmi) è un numero.
2. Un protocollo di deriva. Quello qui sopra. Una foto con pelle, bianco e dettaglio piccolo, una catena di modifiche scollegate, quattro controlli a ogni passo, il passaggio di rottura segnato. Funziona con Seedream 5.5 quando sarà alla tua portata, con il modello che usi adesso e con quello che uscirà l’anno prossimo.
3. Una regola. Nessun modello entra nel tuo flusso di lavoro sulla fiducia. Né sulla mia, né su quella di ByteDance, né su quella di una testata che rilancia un comunicato. Prima di farlo entrare lo provi sul tuo file.
Torniamo alla fotocopia della fotocopia. Se qualcuno ti dicesse “ho fatto cento copie e l’ultima è identica alla prima”, la prima reazione non sarebbe crederci né dargli del bugiardo. Sarebbe chiedergli di fartele vedere, tutte e cento, affiancate. ByteDance ne ha mostrata una serie. Adesso tocca a una persona che non lavora per ByteDance fare la sua.
Lunedì mattina, dieci minuti. Scegli la foto, prepara il bianco di riferimento, scrivi la tabella. Se il modello che usi già oggi regge più passaggi di quanto pensavi, lo sai. Se ne regge meno, lo sai anche questo, e sai quanti.
Se lo fai, scrivimi cosa è venuto fuori: quanti passaggi, su quale modello, e dove si è visto il primo cedimento. Sono i dati che oggi mancano, e li possiamo mettere insieme noi.
Luca
Articoli correlati
- Perché le tue immagini AI peggiorano ad ogni modifica (e come evitarlo)
- Le immagini AI stanno per cambiare mestiere, e con loro il tuo
- Midjourney ha lanciato l’editor oggi. Nemmeno loro sanno ancora cosa può fare davvero.
- FLUX Kontext per Fotografi: Rispondo ad alcune domande
Fonti
- ByteDance Seed, “More Realistic Images, More Stable Editing Across 100 Rounds: Introducing Seedream 5.5”, 09/11/2026
- The Decoder, Matthias Bastian, 09/11/2026
- The Next Web, Ana Maria Constantin, 09/11/2026
- AnchorEdit, arXiv 2606.11751, v1 10/06/2026, v2 15/06/2026
- I2EBench2.0, arXiv 2606.15570, 14/06/2026
- Dreamina/CapCut, “Where Can You Use Seedream?” (riferita a Seedream 5.0), 22/10/2026
Fonti: ByteDance Seed (F1), The Decoder (F2), The Next Web (F3), AnchorEdit (F9), I2EBench2.0 (F8), Dreamina/CapCut (F6, solo per Seedream 5.0). Il dato EdiVal “fino al terzo turno” viene dal registro interno del 07/11 (F10, dossier Adobe EditAgent).
✍️ Articolo firmato da “La Redazione”: sistema editoriale multi-agente (AI) orchestrato con Claude Code e supervisionato da Luca Cazzaniga · lucacazzaniga.it
Leggi anche


