

 14 min di lettura
I video AI sanno come va il mondo, o solo come sembra?
Runway fa muovere un braccio robotico con un modello video. Il test è utile, ma i numeri sono tutti suoi.
📌 Questo pezzo parla di robot, ma non è scritto per chi costruisce robot. Il braccio meccanico di Runway è un esame con voto: uno dei rari casi in cui un modello video viene misurato su qualcosa che si conta, invece che su “sembra vero”. Alla fine ti lascio un modo pratico per leggere i comunicati con i numeri e un criterio per guardare i video AI con occhio più allenato.
Pensa a un regista prima di girare una scena. Ha in testa lo storyboard: la mano si allunga, afferra il bicchiere, il bicchiere si solleva. Non l’ha ancora filmato, ma il film nella sua testa c’è già, e guida i gesti di tutti sul set.
Tienila come immagine, non come spiegazione scientifica. Ma è l’immagine più vicina a quello che ha fatto Runway. Ha preso un modello addestrato sui video e gli ha chiesto due cose insieme: prevedere il video di quello che sta per succedere e, nello stesso momento, prevedere i movimenti con cui un braccio robotico può farlo succedere (Runway, comunicato dell’11 novembre 2026).
Si chiama Praxis-1. E per chi fa video, immagini o contenuti con l’AI, la parte interessante non è il robot. È che per una volta un modello video viene messo davanti a un oggetto vero, dove l’errore si vede subito e si conta. Quando il bicchiere cade, non puoi dire che l’inquadratura era comunque bella.
Riepilogo Articolo - Luca Cazzaniga
1. Cosa è uscito davvero (e cosa no)
Partiamo dai fatti, perché i titoli dei giornali qui hanno semplificato.
Praxis-1 è disponibile dall’11 novembre 2026. In realtà era stato presentato a fine settembre, ma con accesso limitato a partner selezionati: quello di novembre è il rilascio aperto (The Decoder, 14 novembre 2026).
La formula esatta usata da Runway è “open weights under the Apache 2.0 license”, con tutto il necessario per eseguire e adattare il modello, uso commerciale incluso (Runway, 11 novembre 2026). Nel repository ufficiale ci sono i pesi, il codice per far girare il modello e il codice per adattarlo (GitHub, runwayml/praxis-1-oss).
Che cosa significa “pesi aperti”? Immagina un cuoco che ti regala il suo cervello già addestrato, con il manuale per adattarlo alla tua cucina. Non ti regala i libri su cui ha studiato. Ecco la differenza: i dati di addestramento non risultano rilasciati. Il fine-tuning, cioè l’adattamento, usa un dataset pubblico di terzi, non quello di Runway.
Il titolo di The Decoder parla di “open source”. La fonte primaria dice una cosa più precisa, e io mi tengo alla fonte primaria. Per te cambia poco se vuoi solo usarlo, cambia molto se ti chiedi con cosa è stato nutrito: quello non puoi saperlo.
Un dato pratico, per togliere ogni illusione: il modello richiede una GPU da 80 GB (Runway Research, novembre 2026). Una versione compressa su una scheda da 32 GB è, per ora, una stima non misurata (The Decoder). Non è roba da laptop.
2. Come funziona, senza formule
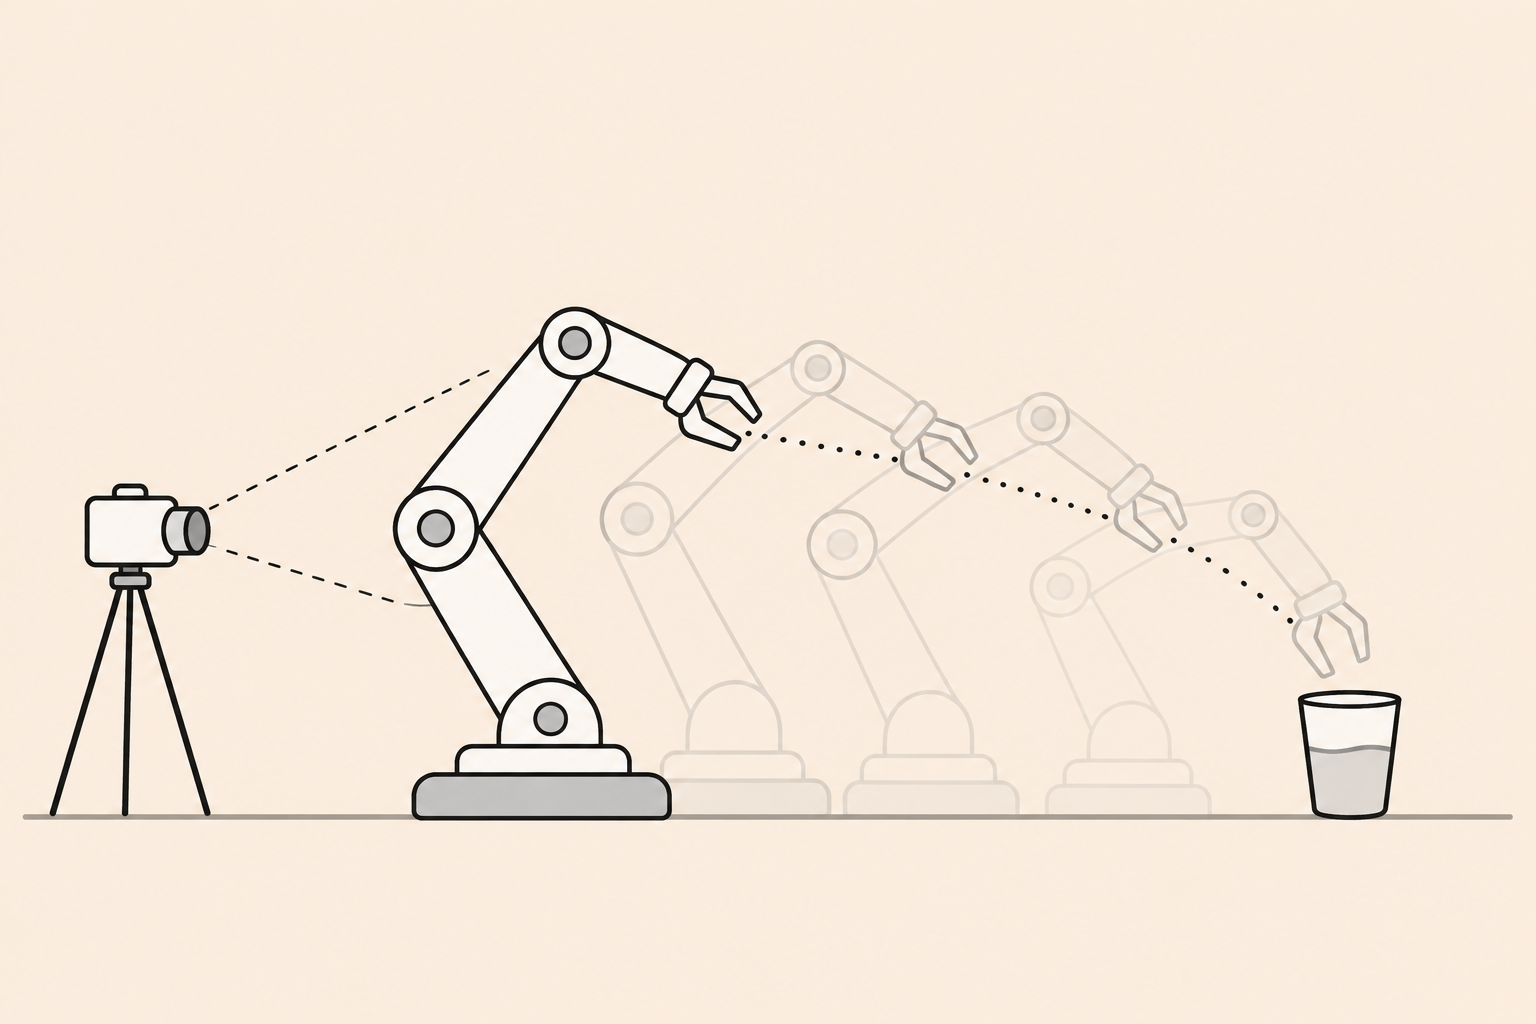
A ogni chiamata il modello riceve tre cose: l’istruzione (per esempio “metti il pezzo nella scatola”), le immagini delle telecamere e la posizione attuale del braccio. In risposta restituisce un video del futuro previsto e, insieme, 1,6 secondi di movimento: 24 righe di azione a 15 al secondo (Runway Research).
Pensa a un copilota che legge il percorso a voce alta: “tra poco curva a sinistra, tieni la traiettoria”. Il modello fa il percorso nella testa e, in parallelo, dice al braccio come muoversi per seguirlo. Una piccola parte dedicata traduce quello che il modello “vede” nel futuro in comandi per i motori.
Su quale modello video sia costruito, Runway è vaga: dice solo che Praxis-1 è “built on the same large-scale video pretraining behind our general world models”, cioè costruito sullo stesso addestramento iniziale su enormi quantità di video che sta dietro ai suoi modelli del mondo (Runway, 11 novembre 2026). Non dice quale modello specifico sia la base.
Andy Chen, il responsabile della robotica di Runway, la mette così (The Robot Report, 12 novembre 2026):
“It learns how the world works before it learns to act.”
Impara come funziona il mondo prima di imparare ad agire. Tieni a mente questa frase: la riprendiamo tra poco, perché è la tesi di Runway, non un fatto dimostrato.
3. I risultati, letti come si legge un comunicato
Una premessa che vale per tutto il paragrafo: tutti i numeri che seguono sono test di Runway. Nessuno li ha ripetuti in modo indipendente. Lo dicono esplicitamente sia The Decoder sia eWeek. Quindi ogni volta che leggi un numero, mettici davanti “secondo Runway”.
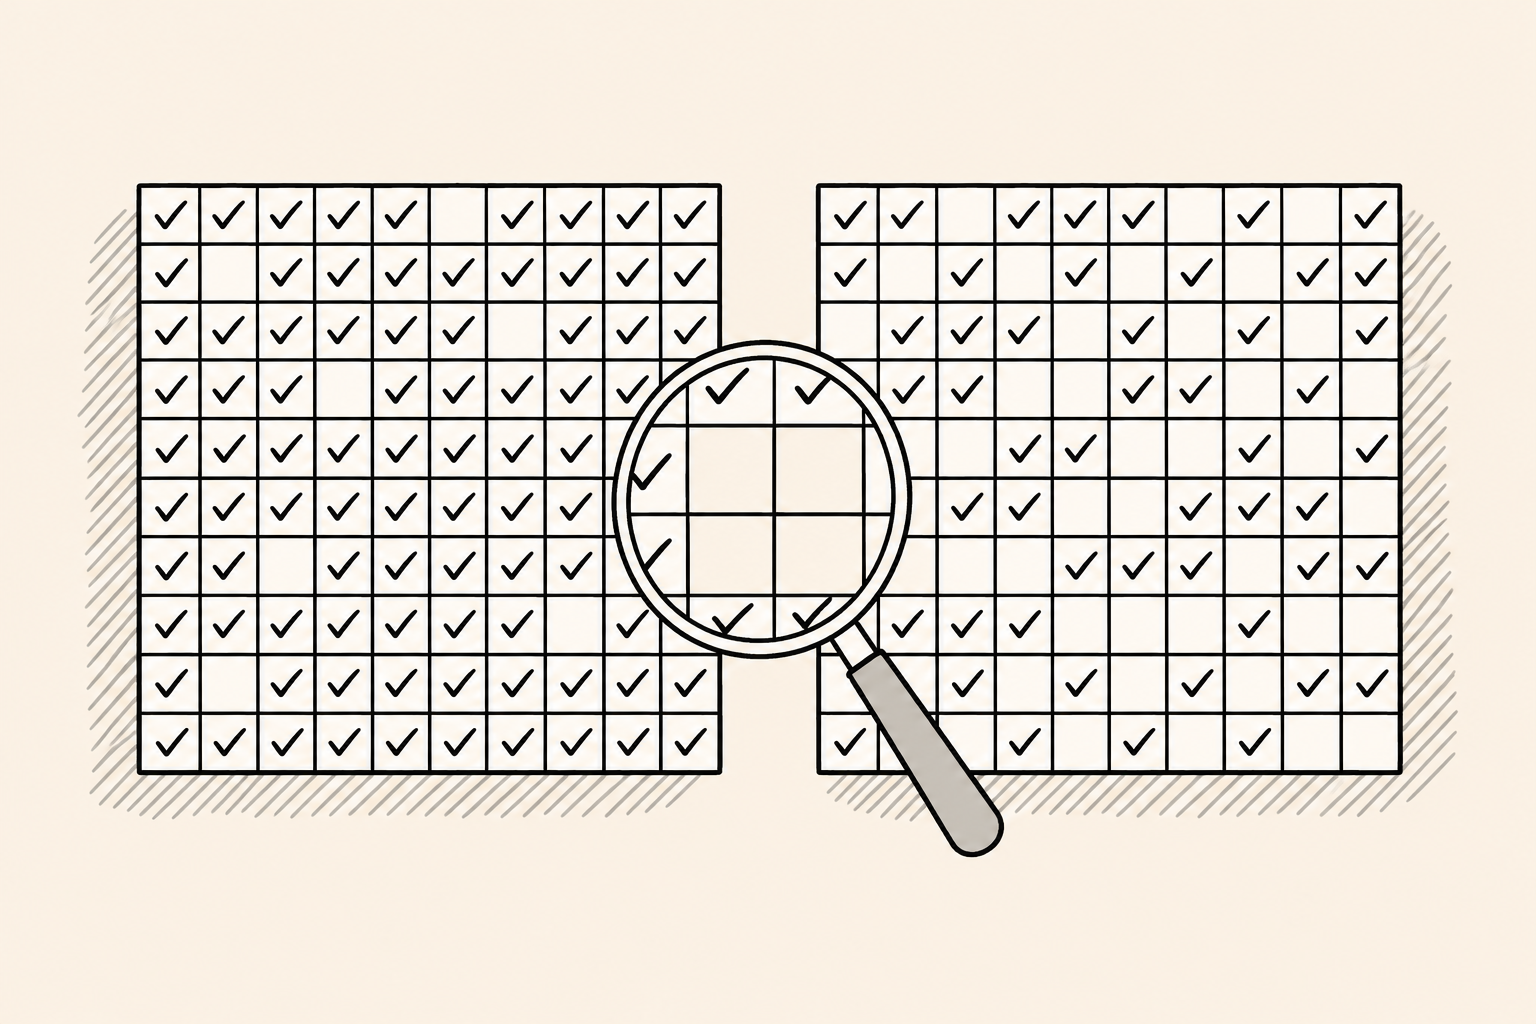
Il robot vero. Su un braccio reale (un Franka FR3), Praxis-1 ha portato a termine 88 prove su 100. Il rivale scelto da Runway, FLUX 3 Action, ne ha riuscite 80 su 100. Le prove sono 10 compiti con un solo oggetto, ripetuti 10 volte ciascuno, nelle sessioni del 2 novembre (Runway Research).
Guarda bene quel numero. È un campione piccolo, raccolto in una finestra breve, contro un avversario scelto da chi ha organizzato la gara. Otto punti su cento prove non bastano per dire che un modello sia nettamente migliore dell’altro. Io lo leggo come un numero che si conta e che ti invita a fare le domande giuste: chi ha fatto il test, su cosa, contro chi.
La simulazione. Su RoboLab-120, un banco di prova in simulazione di NVIDIA, Praxis-1 arriva al 46,2% (555 prove su 1.200). Tradotto: riesce in meno di un compito su due. Secondo Runway è il primo tra i modelli di questo tipo (i “world action model”), ma quinto in assoluto: sopra ci sono, per esempio, AMP1 all’86,0%, SenseNova-RoboRSI al 57,1% e Lakeside al 51,0% (Runway Research; “quinto in assoluto” anche su The Decoder).
Un dettaglio che mi fa andare piano: eWeek, consultando la classifica pubblica di NVIDIA, non ha trovato Praxis-1 elencato, mentre altre fonti riportano il 46,2% (eWeek, 12 novembre 2026). Per questo il “secondo Runway” qui non è un vezzo.
Dopo il fine-tuning. Su un altro test in simulazione (RT-1, su SimplerEnv), dopo un adattamento con circa 95 ore di dati, Praxis-1 arriva all’80,0% contro il 52,4% della policy RT-1 originale, cioè il programma che decide i movimenti del robot (Runway Research).
Il compito nuovo. Dopo circa 29 minuti di dimostrazioni, ha sgomberato una pila di assi mai vista per 6 volte su 10. Su un compito più semplice, 15 su 15 (The Robot Report). Ma attenzione: secondo eWeek quel 6 su 10 è in un magazzino simulato, e un test fisico non è riportato (eWeek).
I limiti, dichiarati da Runway stessa. Il modello confonde oggetti simili (è l’errore più frequente sul robot reale), fatica con istruzioni vaghe e i compiti lunghi, da dare con un solo comando, restano difficili (Runway Research). E un modello base non controlla un robot nuovo senza un addestramento specifico per quel robot (The Decoder).
Sono errori di un sistema che comanda un braccio. Non sono errori di fisica nei video.
Il quadro, secondo eWeek, è questo: il raggio dei test è molto più ristretto del lavoro di un robot commerciale, e l’affidabilità in uso continuo non è dimostrata. Un buon risultato su compiti semplici non è un robot pronto per il lavoro vero.
4. Il contrappeso: realismo non è comprensione
Torniamo alla frase di Chen e al regista con lo storyboard. L’immagine è seducente: un modello che “immagina” il futuro come lo immagina una persona. Fermiamoci qui, perché è proprio quello che non possiamo dire. Se ti interessa il lato opposto della stessa medaglia, il realismo che vuole solo sembrare tale, ne ho scritto in GTA 6 non vuole essere realistico. Vuole sembrarlo. E perché è un’ottima notizia per te.
La tesi di Runway è esplicita. Nel suo manifesto scrive che per prevedere il fotogramma successivo un modello video “must learn how the world works” (Runway, Universal World Simulator, dicembre 2025), e chiama i world model “learned approximators of physics”, approssimatori appresi della fisica. È una tesi di parte, legittima, ma di parte.
Cosa dice chi ha provato a misurarlo da fuori? Il paper Physics-IQ, pubblicato negli atti di WACV 2026 (una conferenza scientifica con revisione tra pari), ha messo alla prova modelli come Sora, Runway, Pika, Lumiere, Stable Video Diffusion e VideoPoet. La conclusione: la comprensione dei principi fisici è “severely limited”, gravemente limitata (Motamed et al., WACV 2026; arXiv). E la frase che conta di più:
“Visual realism does not imply physical understanding.”
Il realismo visivo non implica comprensione fisica.
Però, per onestà, il quadro non è tutto nero: alcuni casi di test sono stati risolti, quindi certi principi potrebbero essere apprendibili guardando i video, anche se restano sfide importanti (stessa fonte).
Ora il limite, e non è piccolo: i modelli testati sono del 2024. Physics-IQ non dice nulla su Praxis-1, né su Gen-4.5. Il confronto non è alla pari, e non lo uso come sentenza. Lo uso come criterio di lettura: una domanda ancora aperta, non una risposta chiusa. (Che l’industria lo consideri un metro serio lo suggerisce il fatto che NVIDIA dichiari di andare bene su Physics-IQ con il suo Cosmos 3, ma è un’autodichiarazione).
Dove sta allora Praxis-1? Questa è la mia lettura, non un fatto: è un indizio pratico. Un modello addestrato a prevedere video, con un piccolo adattamento, riesce a comandare un braccio in compiti stretti. Quindi le regolarità che ha imparato dai filmati servono ad agire. Ma “servono ad agire in un compito stretto” non è “conosce le leggi della fisica”. Prevedere il prossimo fotogramma non è immaginare come farebbe un bambino che afferra un bicchiere: è una regolarità statistica che, in compiti stretti, basta per muoversi.
Un esempio che conosci: l’arredatore che ha visitato dieci milioni di case e sa cosa sta bene dove. Non ha gusto, ha statistica. Funziona benissimo finché la casa assomiglia alle altre. (Di quanto la statistica possa tradire un’immagine ho parlato in Perché l’AI Genera Ancora Mani con Sei Dita (E Cosa Ci Insegna).)
Runway stessa, nel suo manifesto, ha una frase che mi piace perché non è un comunicato (Runway, Universal World Simulator):
“Science is about understanding reality. Art is about transcending it.”
La scienza capisce la realtà, l’arte la oltrepassa. Se sei un creativo, tienila in tasca.
5. Runway non è sola, e questo non è un progetto laterale
Se ti viene da pensare che il robot sia una curiosità, guarda il contesto.
NVIDIA ha presentato Cosmos 3 il 31 maggio 2026: un modello del mondo aperto che unisce ragionamento e generazione su testo, video, immagini, suono e azioni, e produce anche dati d’azione come gli angoli dei giunti e la posizione della pinza (NVIDIA Blog, 31 maggio 2026). La licenza (OpenMDW 1.1, della Linux Foundation) copre pesi, codice, documentazione, benchmark e anche i dataset. Ecco il contrasto con Runway: lei i dati non li apre, NVIDIA sì.
Google DeepMind ha presentato Genie 3 il 5 agosto 2025: mondi interattivi a 24 fotogrammi al secondo e 720p, coerenti per alcuni minuti, proposti anche per addestrare agenti e robot. Resta un’anteprima di ricerca limitata, con limiti dichiarati: azioni possibili ridotte, sessioni di minuti, testo illeggibile (Google DeepMind, 5 agosto 2025).
Runway ha lanciato GWM-1 l’11 dicembre 2025, costruito su Gen-4.5, in tre varianti: Worlds, Robotics, Avatars (TechCrunch, 11 dicembre 2025). La variante Robotics serve per dati sintetici e per valutare le policy dei robot, ed è offerta via SDK, un kit per sviluppatori, cioè si integra nel software di chi costruisce robot. Runway era in trattativa con aziende robotiche (Runway Research, 11 dicembre 2025).
TechCrunch, nel maggio 2026, racconta che Runway è nata dalla domanda “Can we use AI to make everyone a filmmaker?” e che oggi punta a battere Google. Secondo l’articolo, l’unità robotica lanciata nel 2025 ha già prodotto test e installazioni nel mondo reale (è una parafrasi della giornalista, non una citazione) (TechCrunch, 15 maggio 2026). La stessa giornalista fa un’osservazione che mi sembra il modo giusto di tenere i piedi per terra: il salto da video a ragionamento generale non è ancora dimostrato.
Chen, intanto, dichiara che “the frontier of robotics will be discovered through real-world applications, not in a lab” (The Robot Report): la frontiera della robotica si scoprirà nelle applicazioni nel mondo reale, non in laboratorio. Vedremo.
Una cosa che non so, e che nessuna fonte che ho verificato mi dice: cosa pensi Runway del rapporto tra questa strategia e i clienti creativi. Né il comunicato né l’intervista a Chen ne parlano. Non lo so, e non ci ricamo sopra.
6. Il ponte per chi fa video
Qui devo essere preciso, perché è facile esagerare.
I fatti verificati sono quattro. Runway ha un’unità robotica. GWM Robotics è offerto via SDK. GWM-1 è costruito su Gen-4.5. E Gen-4.5, il modello di video che puoi usare in un abbonamento a pagamento, porta audio nativo, video multi-inquadratura fino a circa un minuto e coerenza dei personaggi (TechCrunch, 11 dicembre 2025).
Il mondo di GWM Worlds ha un esempio che rende l’idea: “Turn around, and what was behind you is still there”, giri su te stesso e quello che avevi dietro è ancora lì (Runway Research, 11 dicembre 2025), a 24 fotogrammi e 720p secondo TechCrunch. La coerenza dello spazio è esattamente il tipo di cosa che a chi fa video interessa.
Poi ci sono due affermazioni di Runway, che tengo separate perché non sono la stessa cosa:
- Praxis-1 parte dallo stesso grande addestramento iniziale su video dei world model generali di Runway (comunicato).
- Secondo Runway, come dato di addestramento iniziale, il video preso dal web vale quanto il video di robot teleoperati per le prestazioni della policy (comunicato).
Il ponte arriva fin qui e non oltre. Non ti dico che il bacino di filmati sia “lo stesso” dei generatori che usi tu, né che Gen-4.5 sia la base di Praxis-1: nessuna fonte lo dice. Il dato utile per te è più modesto: anche per Runway, i video comuni del web hanno valore come materiale di partenza per imparare come va il mondo.
Ora un’ipotesi, e la dichiaro come tale. Poiché Runway ha un’unità robotica e offre GWM Robotics via SDK, mi sembra plausibile che i suoi modelli abbiano ormai un secondo cliente oltre a chi fa video. Cosa significhi per gli strumenti che usi tu, non lo so, e non faccio previsioni su dove migliorano e dove no.
Se l’ipotesi non ti convince, tieni la versione che regge sui fatti: quando leggi i comunicati di un fornitore, ricordati che parlano anche ad altri clienti, non solo a te.
7. Cosa porti a casa
Tre cose, ciascuna con il suo statuto.
1. Leggi un video AI come leggeresti la previsione di un bravo imitatore. (È una mia lettura, ancorata a Physics-IQ, non una conseguenza dei dati di Praxis-1.) Un modello che ha visto una quantità enorme di filmati sa come le cose di solito si muovono. Aspettati coerenza nel caso comune e guarda con più attenzione il caso insolito: un oggetto che fa qualcosa di raro, una scena che non assomiglia a nessuna scena tipica. Qui il robot è un’analogia, non una prova: gli errori di Praxis-1 (oggetti simili confusi, istruzioni vaghe, compiti lunghi) sono di un programma che comanda un robot, non difetti di fisica nei video.
Il robot ha dato un numero perché lì l’errore costa. Su una clip per i social l’errore lo guardi tu, e decidi tu. Quel controllo non va delegato.
2. Quando un’azienda annuncia dei numeri, fai tre domande. Chi ha fatto il test? Su quanti tentativi? Contro chi? Applicale a 88 su 100 (campione piccolo, rivale scelto da Runway) e al 46,2% (primo tra i modelli simili, quinto in assoluto). Non è cinismo, è metodo: stesse domande per qualsiasi comunicato di un generatore di video. Un esercizio di smontaggio dello stesso tipo lo trovi in Le Papere AI di Sanremo: non ti dico se è bello o brutto. Smontiamo la macchina che c’è dietro.
3. Distingui i pesi aperti dall’open source. Se un modello è “aperto”, chiediti cosa lo è: i pesi, il codice, i dati. Con Praxis-1 hai il cervello e il manuale, non i libri. Con Cosmos 3 anche i dataset. Per un creativo conta quando devi scegliere con cosa lavorare e cosa puoi sapere dell’origine di quello che usi.
Cosa fare adesso
Prendi il generatore di video che usi di più e fagli due richieste: una scena comune, una scena insolita (qualcosa che cade in un modo strano, un oggetto che rimbalza su una superficie inusuale). Confronta. Non ti serve un laboratorio: ti serve un quarto d’ora e un occhio allenato. Se vuoi, scrivimi cosa succede nei casi strani: sono quelli che mi interessano di più.
Luca
Articoli correlati
- GTA 6 non vuole essere realistico. Vuole sembrarlo. E perché è un’ottima notizia per te
- Perché l’AI Genera Ancora Mani con Sei Dita (E Cosa Ci Insegna)
- Le Papere AI di Sanremo: non ti dico se è bello o brutto. Smontiamo la macchina che c’è dietro
Fonti
- Runway, “Praxis-1 is now available”, 11 novembre 2026
- Runway Research, “Praxis-1: video pretraining to robot control”, novembre 2026
- GitHub, runwayml/praxis-1-oss
- The Decoder, Tomislav Bezmalinović, 14 novembre 2026
- The Robot Report, Brianna Wessling, 12 novembre 2026
- eWeek, Kezia Grace Jungco, 12 novembre 2026
- Motamed et al., “Do generative video models understand physical principles?”, atti WACV 2026 (arXiv)
- Runway Research, “Introducing GWM-1”, 11 dicembre 2025
- Runway, “Universal World Simulator”, dicembre 2025
- TechCrunch, Ivan Mehta e Rebecca Bellan, 11 dicembre 2025
- TechCrunch, Rebecca Bellan, 15 maggio 2026
- NVIDIA Blog, Ming-Yu Liu, 31 maggio 2026
- Google DeepMind, “Genie 3”, 5 agosto 2025
✍️ Articolo firmato da “La Redazione”: sistema editoriale multi-agente (AI) orchestrato con Claude Code e supervisionato da Luca Cazzaniga · lucacazzaniga.it
Leggi anche


