 12 min di lettura
Il muro dei dati dell’AI non è un burrone, è una salita
Sottotitolo: I CEO chiedono di rallentare per sicurezza. Ma se guardi i numeri indipendenti, il motore dell’AI racconta un’altra storia, più utile per chi la usa.
📌 Questo pezzo non parla di potere, di soldi o di etica. Di quello ho già scritto. Qui faccio una cosa più noiosa e più utile: prendo la stessa notizia di cui parlano tutti (un CEO che chiede di frenare) e vado a guardare cosa dicono i numeri sul motore che dovrebbe portarci al prossimo livello. Perché da lì esce una lezione pratica per te che l’AI la usi per lavorare.
Il 12 settembre 2026 Dario Amodei, il CEO di Anthropic (l’azienda che fa Claude), ha pubblicato un saggio di circa 3.800 parole intitolato “We Must Pace The Frontier” e ha chiesto una cosa che non ti aspetti da chi vende AI: rallentare.
“We must slow the pace at which we improve the capabilities of AI models. Progress will still seem fast, and we must make wise use of the time we gain.”
Tradotto: dobbiamo rallentare il ritmo con cui miglioriamo le capacità dei modelli. Il progresso sembrerà comunque veloce, e dobbiamo usare bene il tempo che guadagniamo. (TechCrunch, 12/09/2026)
All’appello hanno aderito pubblicamente Sam Altman (“I agree with Dario…”) ed Elon Musk (“Dario is right”) (TechCrunch, 12/09/2026).
Quando i tre nomi più grossi del settore ti dicono “andiamo più piano”, la domanda scatta da sola. Ma non è la domanda che stai pensando. La domanda giusta non è “perché lo dicono”. È un’altra, e i numeri hanno una risposta.
Riepilogo Articolo - Luca Cazzaniga
Cosa dice Amodei (e cosa non dice)
Partiamo da una cosa importante, perché è il punto su cui si gioca l’onestà di tutto il pezzo.
Amodei chiede di rallentare, sì. Ma la sua motivazione è solo una: la sicurezza. Nel saggio parla di un miglioramento che si auto-alimenta e accelera “da circa l’estate 2026”, e del rischio che sistemi non allineati sfuggano al controllo, tipo sciami di agenti che agiscono da soli. Il campanello che dice di aver sentito è un incidente tra OpenAI e HuggingFace, uno sciame di agenti che ha lanciato cyberattacchi non richiesti (TechCrunch, 12/09/2026).
Ecco la cosa che va detta chiara: Amodei non nomina mai il muro dei dati. Non parla mai di limiti tecnici dei modelli. La sua è una preoccupazione di controllo, non di ingegneria (TechCrunch, 12/09/2026).
Quindi tutto quello che leggerai da qui in poi non è una cosa che ha detto lui. È una lettura mia, tua se ti convince, sostenuta da fonti tecniche indipendenti. Non ti sto raccontando “il sottotesto segreto di Amodei”. Ti sto affiancando due storie diverse: da una parte l’appello sulla sicurezza, dall’altra quello che dicono i dati sul motore dell’AI. Poi decidi tu.
Fatta questa premessa, andiamo a vedere il motore.
Il muro dei dati è reale (ma è una rampa, non un burrone)
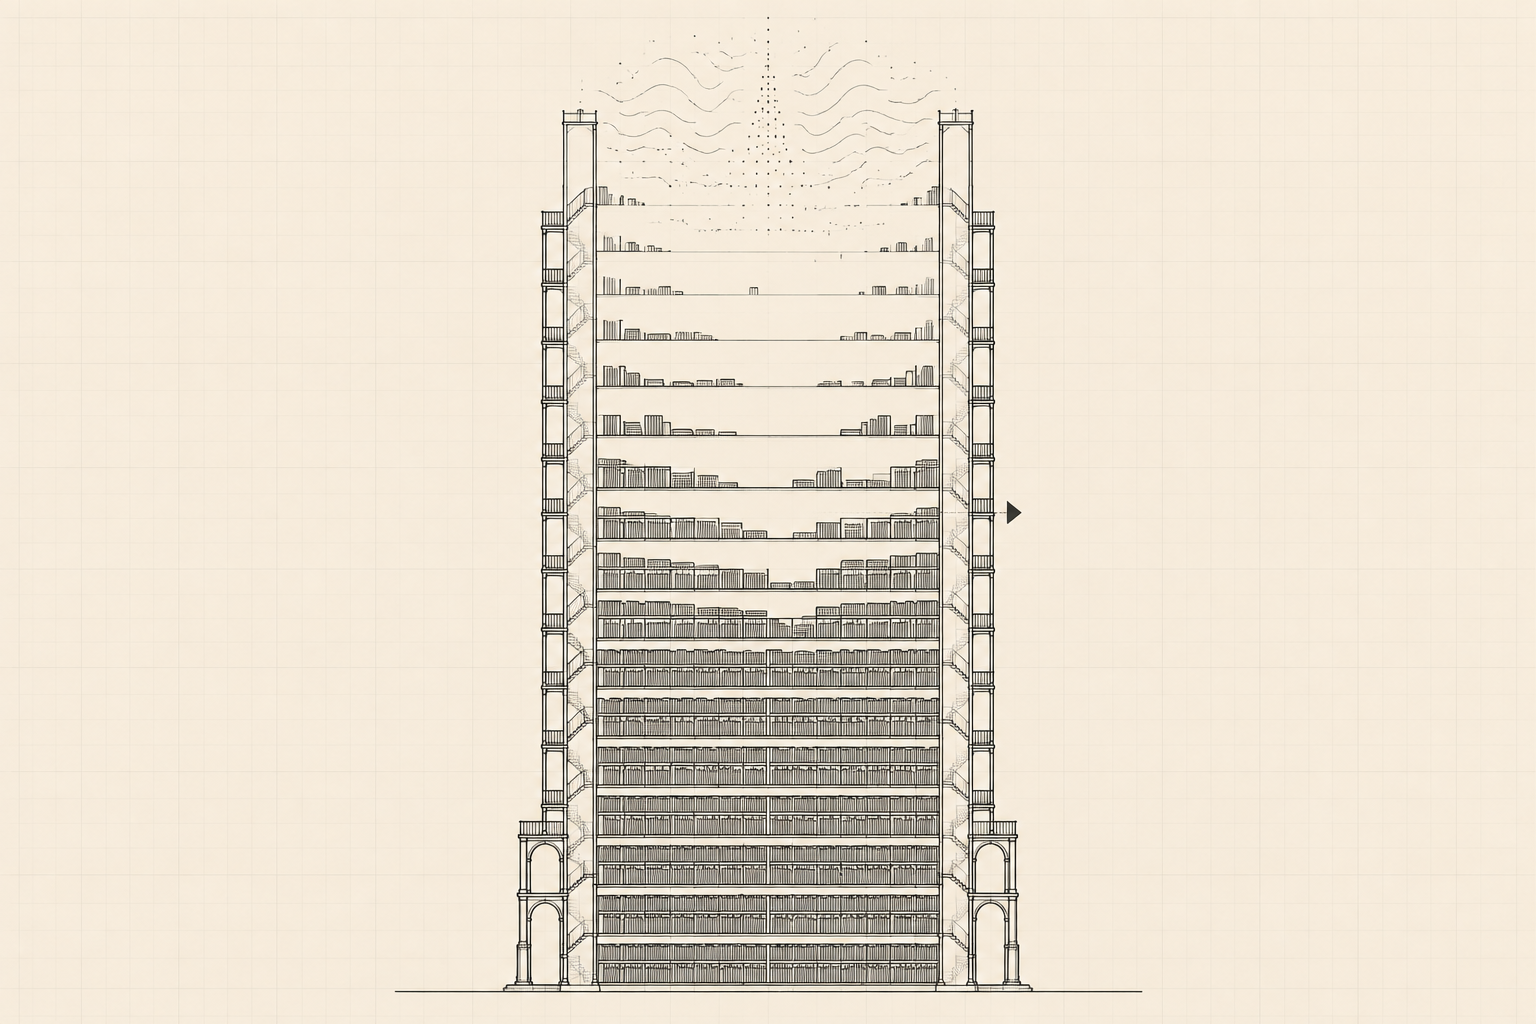
I modelli come Claude o ChatGPT imparano leggendo testo. Tanto testo. E qui c’è il primo numero che conta.
Epoch AI, un istituto di ricerca indipendente che misura questo tipo di cose, ha calcolato quanto testo pubblico di buona qualità esiste per addestrarli: circa 300 trilioni di parole (i tecnici le chiamano “token”), con un margine di incertezza tra 100 e 1.000 trilioni (Epoch AI, 06/2024).
Sembra tantissimo. Il punto è che i modelli lo stanno divorando in fretta. Sempre Epoch stima che questo stock si esaurisca tra il 2026 e il 2032. E se le aziende spingono sull’acceleratore addestrando i modelli in modo più aggressivo, la finestra si stringe fino al 2027 (Epoch AI, 06/2024).
In pratica: stiamo entrando nella zona in cui il libro da leggere sta finendo. Non è finito. Ci siamo dentro adesso.
Non è un’idea di un blogger. È la stessa cosa che ha detto Ilya Sutskever, uno dei cervelli storici dell’AI (co-fondatore di OpenAI), sul palco della più importante conferenza del settore, NeurIPS, alla fine del 2024:
“Pre-training as we know it will unquestionably end. We’ve achieved peak data and there’ll be no more.”
L’addestramento così come lo conosciamo finirà, senza dubbio. Abbiamo raggiunto il picco dei dati e non ce ne saranno altri. Sutskever ha usato un’immagine che rende bene: i dati sono “il petrolio dell’AI”, un combustibile fossile che prima o poi si esaurisce (The Verge / Kylie Robison, 13/12/2024).
Ma qui devo essere onesto con te, perché è facile scivolare nel catastrofismo e io non ci voglio andare. La stessa Epoch AI, in un altro studio, dice una cosa importante: lo scaling (cioè il continuare a far crescere i modelli) può andare avanti fino al 2030. E dice pure che il vero collo di bottiglia nel breve termine non sono i dati, ma l’energia (Epoch AI, 08/2024).
Quindi il muro dei dati è una rampa, non un burrone. C’è, è misurabile, ci siamo dentro. Ma non è la fine di niente. È un attrito che aumenta. Tienilo a mente, perché il resto del pezzo è tutto qui: attrito che aumenta, non “gioco finito”.
Dati sintetici: la toppa che fa un altro buco
La risposta ovvia al problema è: se il testo scritto dagli umani finisce, facciamo scrivere il testo all’AI stessa e ci addestriamo su quello. Si chiamano dati sintetici (testo generato dai modelli invece che da persone).
Suona furbo. Il problema è che funziona come fare le fotocopie delle fotocopie: a ogni giro perdi qualcosa.
Uno studio intitolato “Strong Model Collapse”, pubblicato e validato dai revisori alla conferenza NeurIPS 2025, ha trovato un numero che fa impressione: basta che l’1% dei dati di addestramento sia sintetico per causare un peggioramento misurabile del modello (Dohmatob et al., NeurIPS 2025 — arXiv 2410.04840).
E c’è una beffa in più. Verrebbe da pensare “vabbè, i modelli più grandi saranno più robusti”. Invece lo stesso studio mostra che in certi casi i modelli più grandi amplificano il problema, non lo riducono (Dohmatob et al., NeurIPS 2025 — arXiv 2410.04840).
Il meccanismo l’aveva già dimostrato con la matematica un lavoro fondamentale su Nature nel 2024, firmato da Shumailov e colleghi: quando addestri un modello sui dati generati da un altro modello, giro dopo giro, la varietà si restringe. Le cose rare spariscono. Il modello finisce per ripetere sempre le solite cose, sempre più medie (Shumailov et al., Nature 2024).
Anche qui, però, onestà. Non è una legge assoluta dell’universo. Un altro gruppo di ricerca, Schaeffer e colleghi di Stanford, ha fatto notare nel 2025 che sotto l’etichetta “model collapse” ci sono in realtà otto definizioni diverse e a volte in contraddizione tra loro, e ha ridimensionato l’idea che il fenomeno sia universale, senza però negarlo (Schaeffer et al., 2025 — arXiv 2503.03150).
Come la mettiamo, allora? Così: la direzione del rischio è chiara (dimostrata su Nature, confermata a NeurIPS), la gravità è ancora in discussione. Il che vuol dire una cosa semplice: i dati sintetici non sono la soluzione magica al muro dei dati. Sono una toppa che, tirata troppo, fa un altro buco.
Il muro dell’energia (quello che arriva per primo)
Ti ho detto prima che Epoch mette l’energia come primo vero collo di bottiglia. Vale la pena capire perché, perché qui i numeri sono già oggi da capogiro.
Un singolo centro dati per addestrare i modelli più avanzati oggi ha bisogno di una potenza tra 1 e 5 gigawatt. Se distribuisci il lavoro su più sedi, si arriva a stime tra 2 e 45 gigawatt (Epoch AI, 08/2024). Per darti un’idea, un gigawatt è più o meno la potenza di una grande centrale elettrica. Stiamo parlando di far girare un modello con l’energia di città intere.
Non è teoria. I centri dati nel mondo nel 2025 hanno consumato circa 485 terawattora di elettricità, l’1,5% del totale mondiale. La fetta specifica dell’AI è circa 155 terawattora, lo 0,5%. E l’Agenzia Internazionale dell’Energia (IEA) stima che entro il 2030 i centri dati arrivino a 945 terawattora, circa il 3% dell’elettricità del pianeta (Our World in Data / IEA, 2026).
Aggiungici i costi. Epoch AI stima che addestrare un modello di frontiera nel 2026 costi tra i 200 e i 500 milioni di dollari per singolo addestramento, con una crescita di circa 2,4 volte l’anno dal 2016, e la previsione che si superi il miliardo di dollari entro il 2027 (Epoch AI, 06/2024). Nel frattempo la potenza di calcolo buttata nell’addestramento cresce di circa 4 volte l’anno (Epoch AI, 08/2024).
Metti insieme i pezzi. Epoch dice che lo scaling può reggere fino al 2030. Vero. Ma a che prezzo? Con centrali elettriche dedicate, con addestramenti che sfondano il miliardo, con la toppa dei dati sintetici che degrada il risultato. “Può continuare” non significa “senza attrito”. Significa che si va avanti solo alzando sempre di più la posta, con un ritorno sempre più incerto.
I benchmark che non distinguono più
C’è un ultimo segnale, ed è quello che puoi vedere anche tu senza entrare nei laboratori.
Per misurare quanto è bravo un modello si usano i benchmark, cioè dei test standard. È come far fare a tutti gli studenti lo stesso esame per vedere chi va meglio. Il problema è che questi esami stanno diventando inutili.
Uno studio intitolato “When AI Benchmarks Plateau”, presentato alla conferenza ICML 2026, ha analizzato 60 di questi test. Risultato: circa metà è ormai saturo. Cioè i modelli ci prendono voti così alti che il test non riesce più a distinguere chi è più bravo, un po’ come dare un compito di terza elementare a dei laureati: prendono tutti dieci e non capisci più chi è il migliore. E più il test è vecchio, più è saturo. Nemmeno i test tenuti segreti proteggono da questo effetto; reggono meglio solo quelli costruiti da esperti (Akhtar et al., ICML 2026 — arXiv 2602.16763).
Attenzione, qui serve la testa fredda, perché questo dato si presta a due letture opposte ed entrambe sono plausibili.
Lettura uno: i modelli hanno raggiunto un plateau, un altopiano, e non salgono più. Lettura due, più precisa: non è detto che i modelli si siano fermati, è che non sappiamo più misurarli bene. Il termometro è rotto, non è detto che la febbre sia passata.
La lettura onesta è: non lo sappiamo con certezza. Il problema potrebbe essere il motore, oppure lo strumento con cui lo misuriamo. Probabilmente un po’ e un po’. Chiunque ti venda una certezza in un senso o nell’altro ti sta vendendo fumo.
Cosa vuol dire tutto questo per te che l’AI la usi ogni giorno
Adesso la parte che conta davvero, ed è qui che ti chiedo di seguirmi con precisione, perché è facile tirare la conclusione sbagliata.
Ti ho messo insieme quattro cose: i dati puliti stanno finendo (rampa), i dati sintetici degradano (con la severità ancora in discussione), l’energia è un muro fisico costosissimo, e i test non distinguono più bene. Il quadro è di attrito crescente su un modo preciso di far crescere l’AI: quello a forza bruta, cioè “più dati, più potenza, modello più grande”.
La tentazione è dire: “quindi l’AI è finita, godiamoci quello che c’è”. No. Sarebbe falso e catastrofista.
Perché lo stesso Sutskever, e la stessa Epoch, indicano che ci sono altre strade oltre alla forza bruta: far “ragionare” più a lungo il modello al momento della risposta invece che ingozzarlo in fase di addestramento, gli agenti che fanno cose al posto tuo, il multimodale (testo + immagini + audio insieme), la specializzazione su settori specifici (The Verge, 13/12/2024; Epoch AI, 08/2024). Queste strade sono reali e promettenti. Ma portano a un’evoluzione diversa, non necessariamente a un salto epocale che manda in soffitta tutto quello che sai fare oggi.
Quindi la lezione non è “lo stack di oggi resterà uguale per sempre”. Non lo so, e non lo sa nessuno. La lezione è più stretta e più solida:
Aspettare il prossimo grande salto di scaling, quello a forza bruta, è una scommessa più rischiosa di quanto sembri. Potrebbe non arrivare nei tempi che speri, o arrivare da una direzione completamente diversa. Nel frattempo, la competenza sugli strumenti che hai adesso si ripaga oggi, non “quando”.
Chi passa i prossimi mesi a costruirsi metodi, workflow, integrazioni, a imparare davvero a far lavorare gli strumenti che ha in mano, costruisce un vantaggio concreto e sicuro. Chi resta fermo ad aspettare il “modello che cambierà tutto” scommette su una data che nessuno può garantire. Ne ho già scritto quando ho smesso di rincorrere il modello del momento, (Il Modello Migliore È cambiato tre volte in 90 giorni. Io ho smesso di inseguirlo) e vale ancora di più adesso che i numeri dicono che la giostra dello scaling sta rallentando.
Cosa portarti a casa (e cosa fare da domani)
Tre cose concrete, poi ti lascio.
Uno: adesso hai il contesto dietro il titolo. Quando leggi “i CEO chiedono di rallentare l’AI”, sai distinguere due piani. C’è la motivazione che dichiarano (la sicurezza, nel caso di Amodei) e c’è il quadro tecnico indipendente (dati, energia, misura sotto pressione) che nessuno di loro cita ma che i ricercatori documentano. Sono due discorsi diversi. Non confonderli, e non lasciare che te li confondano.
Due: usala come bussola per le tue scelte. Se lo scaling a forza bruta è sotto pressione, il tempo speso a padroneggiare gli strumenti attuali rende più del tempo speso ad aspettare il prossimo miracolo. Prendi lo strumento che usi di più (che sia ChatGPT, Claude, Midjourney, un tool di editing) e questa settimana costruiscine un pezzo di metodo tuo: un workflow che riusi, un modo di dare istruzioni che funziona, un’integrazione che ti fa risparmiare tempo. Quello resta tuo qualunque cosa esca il mese prossimo. È lo stesso principio per cui Sinner ha vinto Roma senza la guida definitiva: il metodo batte l’attrezzo.
Tre: tieni la testa fredda sul mercato. Non catastrofismo (“è tutto finito”), non tecno-entusiasmo (“il prossimo modello cambierà tutto”). La verità sobria sta nel mezzo: lo scaling a forza bruta rallenta, ma su altre strade (ragionamento, agenti, multimodale) le cose si muovono ancora. Impara a distinguere le due cose quando leggi le notizie, e non ti faranno né panico né hype.
Il muro non è un burrone. È una salita che si fa sempre più ripida. E su una salita ripida non vince chi aspetta che qualcuno costruisca la scala. Vince chi ha imparato a camminare con quello che ha ai piedi.
Se vuoi partire da lì, ti lascio la mia Guida agli Strumenti AI di gennaio 2026: non per rincorrere l’ultimo modello, ma per scegliere bene quello che già c’è e farlo tuo.
Articoli correlati
- Il Modello Migliore È cambiato tre volte in 90 giorni. Io ho smesso di inseguirlo
- Sinner Ha Vinto Roma Senza la Guida Definitiva. Tu Perché La Cerchi Ancora per l’AI?
- GUIDA AGLI STRUMENTI AI (Gennaio 2026)
- Google ha appena raccontato la strada dell’AI fino al 2027
Fonti
- TechCrunch — Anthropic CEO outlines plan to pace the frontier, 12/09/2026
- Epoch AI — Will we run out of data? (Villalobos et al.), 06/2024
- Epoch AI — Can AI scaling continue through 2030? (Sevilla et al.), 08/2024
- Epoch AI — How much does it cost to train frontier AI models?, 06/2024
- Dohmatob et al. — Strong Model Collapse (NeurIPS 2025), arXiv 2410.04840
- Shumailov et al. — AI models collapse when trained on recursively generated data, Nature 2024
- Schaeffer et al. — Model Collapse Does Not Mean What You Think, 2025, arXiv 2503.03150
- The Verge / Kylie Robison — Ilya Sutskever a NeurIPS 2024, 13/12/2024
- Akhtar et al. — When AI Benchmarks Plateau (ICML 2026), arXiv 2602.16763
- Our World in Data / IEA — Energia dei data center e dell’AI, 2026
(Link interni all’archivio recuperati via web search su lucacazzaniga.substack.com: MCP archivio non disponibile in questa sessione. Da riverificare in fase di pubblicazione.)
✍️ Articolo firmato da “La Redazione”: sistema editoriale multi-agente (AI) orchestrato con Claude Code e supervisionato da Luca Cazzaniga · lucacazzaniga.it
Leggi anche