 13 min di lettura
Prima di fidarti di un’AI, cerca il giudice
Sottotitolo: Un’AI ha formalizzato Fermat in undici giorni. La lezione non è che è più intelligente: è che c’era un verificatore esterno che non si può ingannare. Quando c’è, ti puoi fidare in modo diverso.
📌 Questo pezzo parte da una notizia molto tecnica (matematica formale, un teorema famoso, un compilatore) e la traduce in una cosa che serve a te, che con la matematica non ci lavori: capire in quali casi puoi fidarti di un output AI e in quali no. Non ti servirà mai Lean. Ti servirà la domanda che sta sotto. Ci arriviamo con calma, senza gergo.
In undici giorni, decine di programmi AI hanno scritto tredici milioni di righe di matematica. Non è un errore di battitura: tredici milioni.
E qui viene il punto. Un secondo programma, che fa solo il controllore, le ha lette tutte. Una per una. E alla fine ha detto sì.
Quel controllore non si può convincere. Non lo puoi adulare, non lo puoi mettere di fretta, non gli puoi raccontare una storia plausibile sperando che se la beva. O quello che hai scritto regge riga per riga, oppure lui si ferma e ti sbatte in faccia l’errore. Non esistono “dipende da come la vedi”.
Ecco. Tienilo a mente, perché è tutto qui. La notizia che ha fatto rumore questa settimana non parla di un’AI più intelligente. Parla di un’AI che lavora dentro un recinto dove le bugie non passano. E se capisci come funziona quel recinto, capisci anche una cosa molto più utile: quando fidarti di ChatGPT, di Claude o di Gemini, e quando invece no.
Partiamo dai fatti, che sono già abbastanza forti da non aver bisogno di essere gonfiati.
Riepilogo Articolo - Luca Cazzaniga
Cosa è successo davvero (e cosa NON è successo)
Anthropic, l’azienda che fa Claude, ha annunciato una cosa grossa: per la prima volta un sistema AI ha prodotto una dimostrazione completa dell’intero Teorema di Fermat verificata da un computer, dall’inizio alla fine (Anthropic — Formalizing Fermat’s Last Theorem, 2026; conferma indipendente su Nature, 2026).
Prima cosa da mettere in chiaro, perché altrove la trovi raccontata male: non è stato “Claude” a farlo. Il modello usato è un sistema interno di ricerca, che Anthropic descrive come “approssimativamente comparabile a Claude Fable 5.1” (Anthropic, 2026). Non è la versione che apri tu dal browser. È un cugino da laboratorio.
Seconda cosa, ancora più importante. Non ha scoperto niente. Il Teorema di Fermat lo ha dimostrato un umano, Andrew Wiles, nel 1995. L’AI ha preso una versione già esistente di quella dimostrazione (l’esposizione di Darmon, Diamond e Taylor) e l’ha tradotta in una lingua che un computer può controllare passo per passo (Anthropic, 2026; Nature, 2026).
Fermati un attimo su questa differenza, perché è la spina dorsale di tutto il pezzo. C’è differenza tra scoprire e tradurre in modo che una macchina lo verifichi. Una cosa è comporre una sinfonia. Un’altra è ricopiarla nota per nota su uno spartito che una macchina può suonare per controllare che non ci siano errori. Sono lavori diversi, con valore diverso. Chi ti dice “l’AI ha risolto Fermat” ha saltato questa riga. Tu non saltarla.
Detto questo, i numeri restano impressionanti:
- 11 giorni di tempo reale, meno di due settimane (Anthropic, 2026).
- 13 milioni di righe di codice, oltre cinque volte l’intera libreria matematica di riferimento (si chiama Mathlib, è il magazzino condiviso della matematica formalizzata) (Anthropic, 2026).
- 30.300 teoremi dimostrati lungo la strada, di cui 29.500 usati nella prova finale (Anthropic, 2026).
- Non un solo programma, ma decine di programmi AI che lavoravano in parallelo, coordinati tra loro (Anthropic, 2026).
- Un solo matematico umano (Tianyi Peng), che ogni tanto dava un’indicazione dall’alto tipo “questa parte sembra prioritaria”. Non ha scritto la matematica. Ha fatto il direttore d’orchestra, molto da lontano (Anthropic, 2026).
Un lavoro che la comunità dei matematici stimava richiedesse anni, fatto in undici giorni. La velocità è reale. Ma la velocità di esecuzione su un problema aperto non è una scoperta intellettuale. Tienile separate.
Il giudice che non tratta
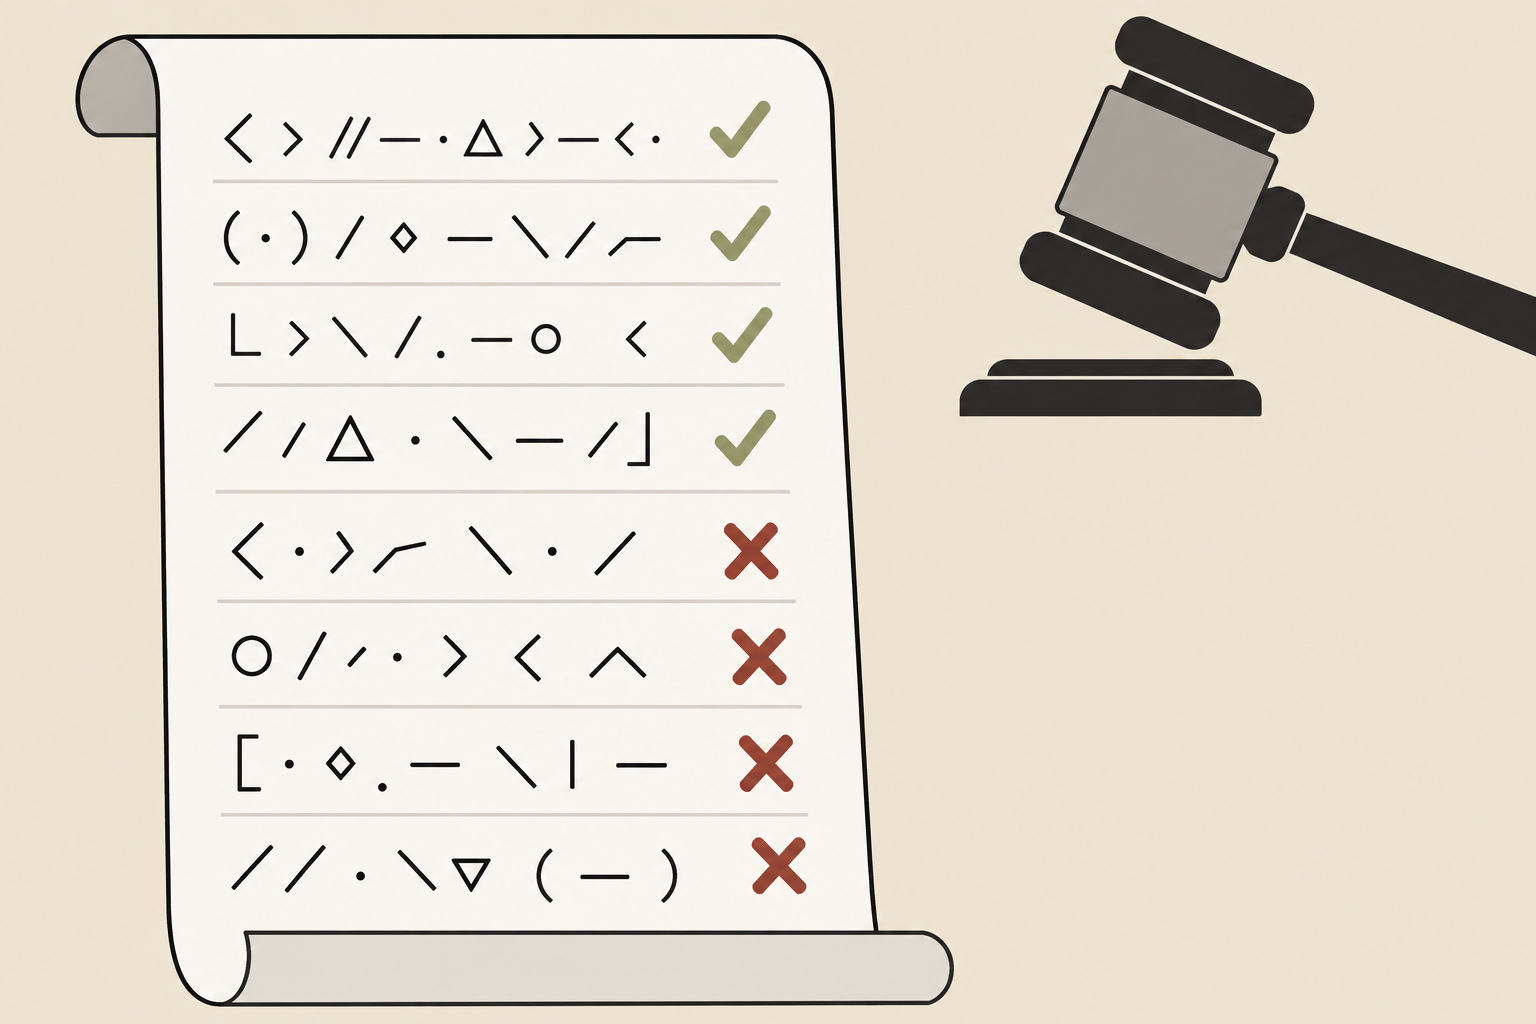
Adesso la parte che conta per te. Quella lingua in cui l’AI ha tradotto la dimostrazione si chiama Lean. E accanto a Lean c’è un programma, il compilatore, che fa una cosa sola: controllare.
Lascia perdere il nome. Immagina un giudice. Un giudice strano, che non ha opinioni, non ha simpatie, non ha fretta e soprattutto non si può corrompere. Tu gli porti un ragionamento fatto di mille passi. Lui parte dal primo e chiede: questo passo segue da quelli precedenti secondo le regole che abbiamo concordato all’inizio? Se sì, va avanti. Se no, si ferma lì e ti dice esattamente dove ti sei rotto.
Non c’è modo di fregarlo. Non puoi dirgli “ma dai, si capisce cosa intendo”. Non puoi scrivere una frase bella e convincente sperando che chiuda un occhio. È il contrario esatto della chat che usi ogni giorno.
Perché la tua chat funziona così: ha letto una montagna di testi e ha imparato che, di solito, dopo certe parole ne vengono bene certe altre. Fa una previsione plausibile. Ed è per questo che a volte inventa con la faccia sicura di chi sa. Le chiamano allucinazioni, ne ho parlato quando ho dovuto spiegare ai miei figli come fa ChatGPT a “sapere” le cose (te lo racconto in Papà, ma come fa ChatGPT a sapere tutto?).
Il giudice di Lean spegne le allucinazioni. Non perché l’AI sia diventata più onesta, ma perché in quel recinto una bugia non passa il controllo. Se il modello inventa un passaggio, il compilatore lo blocca. Punto.
Attenzione, però, a cosa controlla il giudice: controlla che ogni passo segua dal precedente per le regole condivise. Controlla la correttezza logica. Non controlla se il ragionamento è bello, importante o interessante. Ci torniamo, perché è il limite più onesto di tutta questa storia.
Il trucco vero: sbagliare, farsi bocciare, riprovare
C’è una cosa che distingue questo tipo di AI da quella che apri di solito, ed è il pezzo che a me interessa di più.
Quando tu chiedi qualcosa a una chat e ti risponde male, chi si accorge dell’errore? Tu. E tu sei umano: a volte te ne accorgi, a volte no, a volte ci credi perché suona bene. Il feedback dipende da te, ed è lento, incerto, litigabile.
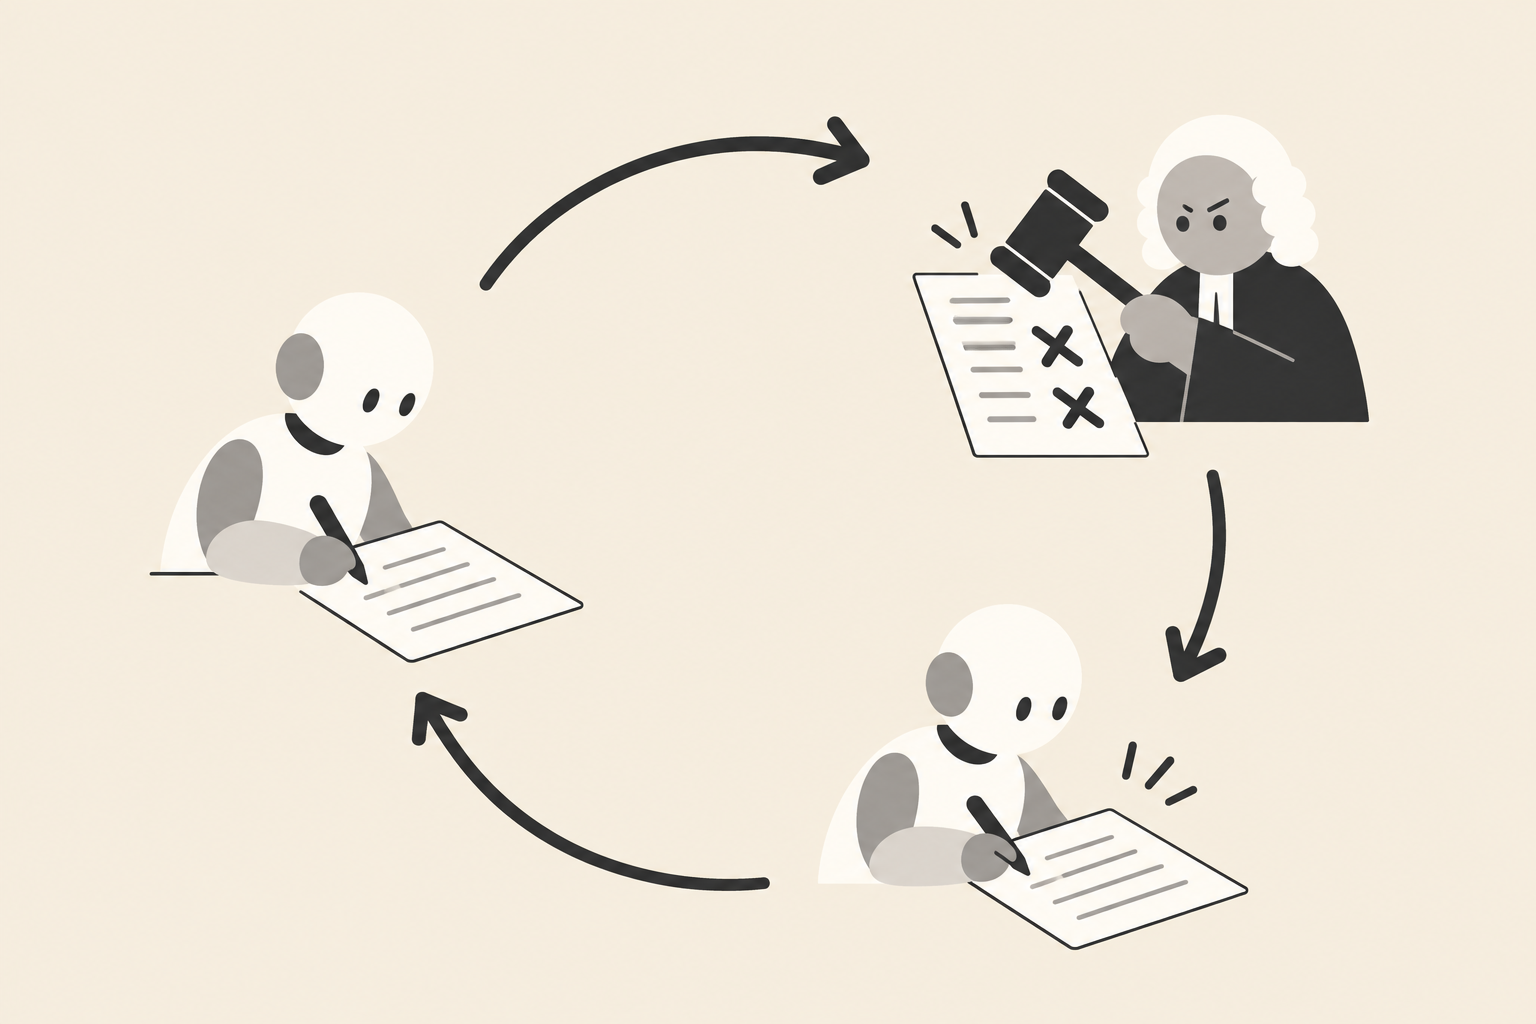
Nel recinto formale il feedback è un altro pianeta. Il modello prova a scrivere un pezzo di dimostrazione, il giudice lo boccia e gli dice esattamente cosa non va, il modello corregge e riprova. E lo può fare all’infinito, senza stancarsi, senza offendersi, senza “secondo me però”. Questo ciclo ha anche un nome tecnico, ma il concetto è quello di un allievo che ha un maestro che non sbaglia mai un voto e lo corregge mille volte al minuto.
Non è teoria. Un altro sistema, Goedel-Prover-V2 di Princeton, è costruito apposta intorno a questo ciclo: il compilatore restituisce l’errore, il modello si autocorregge, iterazione dopo iterazione (arXiv 2508.03613 — Goedel-Prover-V2, 2026).
E qui arriva la conferma più solida, quella delle Olimpiadi della Matematica (l’IMO, la gara più tosta al mondo per studenti). Il sistema AlphaProof di Google DeepMind, che usa Lean come giudice sia mentre impara sia durante la gara, ha preso 28 punti su 42 all’IMO 2024, un livello da medaglia d’argento. E ha risolto il Problema 6, quello che tra i concorrenti umani avevano preso solo in cinque (Nature — AlphaProof, 2025; Google DeepMind, 2024). L’anno dopo, all’IMO 2025, altri due sistemi (Aristotle di Harmonic e Seed-Prover di ByteDance) hanno raggiunto livelli da oro e argento, sempre con soluzioni verificate in Lean (arXiv 2510.01346, 2026; arXiv 2507.23726, 2026).
Adesso attenzione, perché io per primo ti ho detto mille volte di non fidarti dei punteggi sui benchmark, quei test standard su cui ogni azienda giura che il suo modello è il migliore (l’ho scritto per esteso in Ogni settimana esce “il modello migliore di sempre”). E ora ti cito una gara come prova? Sembra che mi contraddica. Non è così, e la differenza è tutta qui:
Questi punteggi contano non perché sono alti, ma perché sono certificati da un terzo che non è umano. In una gara normale l’AI dice “ho risolto” e qualcuno le crede. Qui ogni singola soluzione è passata dal giudice di Lean. Non è il modello che si autovaluta: è il compilatore che ha detto sì. È la differenza tra uno studente che ti giura di aver fatto bene il compito e un compito già corretto da un professore che non sbaglia.
Sulle spalle di gente che non lavora per Anthropic
Una cosa che nella versione trionfale della storia sparisce sempre: Anthropic non ha costruito tutto da zero.
L’operazione si appoggia su tre pezzi già esistenti e gratuiti. Il progetto per formalizzare Fermat esisteva già dal 2024, guidato dal matematico Kevin Buzzard dell’Imperial College di Londra e finanziato con soldi pubblici (l’ente di ricerca britannico EPSRC). C’era già Mathlib, il magazzino condiviso della matematica formalizzata. E c’era Prove2Me, lo strumento che ha permesso a decine di programmi di lavorare insieme senza pestarsi i piedi (Anthropic, 2026; Nature, 2026; AI Weekly, 2026).
Piccolo dettaglio che dice tutto: il primo tentativo di Anthropic è fallito. Senza lo strumento di coordinamento (Prove2Me, nato da un gruppo di ricerca alla Columbia), i programmi non riuscivano a mettere insieme il puzzle (Anthropic, 2026).
Non è una critica ad Anthropic. È come funziona la ricerca: sempre in piedi sulle spalle di chi è venuto prima, e molto di quel “prima” è lavoro pubblico e gratuito. Se leggi solo il comunicato aziendale, questa parte non la vedi. Ma è parte della storia esattamente come i tredici milioni di righe.
Cosa il giudice NON può fare (ed è il punto onesto)
Adesso la sezione che tanti salterebbero, e che invece è quella che ti fa capire davvero il confine.
Il giudice di Lean garantisce una cosa sola: che ogni passo sia logicamente corretto. Non garantisce che la domanda fosse interessante, né che il risultato serva a qualcosa.
Alex Kontorovich lo mette così: Lean certifica che un teorema è corretto anche quando non ti dice niente di utile (Simons Foundation — From Trust to Verification, 2026). Faccio un esempio banale: puoi far certificare al compilatore che 17 + 18 = 35, e con questo non hai imparato nulla che valga la pena. Corretto e interessante sono due cose diverse. Il giudice sa solo dirti la prima.
E c’è la domanda scomoda di Kevin Buzzard, lo stesso che guida il progetto Fermat, quindi non uno scettico da tastiera:
Qualcuno di questi sistemi ci ha mai detto qualcosa di interessante che non sapevamo già?
La risposta, oggi, è no. Le soluzioni AI usano tecniche note su problemi che erano stati trascurati (Simons Foundation, 2026).
Persino Anthropic è onesta su questo: la sua dimostrazione di Fermat è “probabilmente molto più lunga del necessario” e così com’è non è nemmeno integrabile nel magazzino condiviso. E la verifica esterna, per ora, si è fermata alla revisione di Buzzard: nessuna replica indipendente su larga scala (Anthropic, 2026).
Quindi: il recinto formale spegne le allucinazioni, sì. Ma è un recinto. Dentro, la macchina è impeccabile. Fuori, la domanda “ma questa cosa vale la pena farla?” resta tutta umana.
La domanda che porti a casa (e non è “l’AGI è vicina”)
Qui la maggior parte degli articoli ti direbbe: guarda, l’AI ha risolto Fermat, l’intelligenza artificiale generale è dietro l’angolo. Io ti dico l’esatto contrario, e ti spiego perché è più utile.
Questa storia non è un segnale che l’AI sta diventando super-intelligente. È un segnale su una cosa completamente diversa: la verificabilità. Il dominio della matematica formale non è speciale perché lì l’AI è più brava. È speciale perché lì esiste un giudice esterno che non si può ingannare. È un caso di verificabilità superiore, non di intelligenza superiore. Ed è, per definizione, un recinto stretto e chiuso: il contrario della “generalità” di cui parlano quando dicono AGI.
Ecco allora la domanda pratica che ti resta, e vale per qualsiasi strumento AI tu apra domani mattina:
“Lo strumento che sto usando ha un giudice esterno che non può essere convinto? O si sta giudicando da solo?”
Quando c’è un giudice esterno vero (il compilatore che dice se il codice gira, il test che passa o fallisce, il calcolo che torna o non torna), l’allucinazione ha un tetto naturale. Ti puoi fidare in modo diverso, perché non ti stai fidando della bravura del modello: ti stai fidando del giudice.
Quando quel giudice non c’è (l’AI ti scrive un testo, ti propone un’immagine, ti riassume un documento), il rischio è pieno. E l’AI è bravissima a produrre roba plausibile. Il tuo lavoro è distinguere il plausibile dal vero, l’ho già battuto e ribattuto in 100 Milioni di Persone Hanno Letto Questo Post sull’AI.
E c’è un ultimo livello, il più insidioso. Uno studio serio (METR, luglio 2025) ha preso 246 problemi reali di programmazione e sedici sviluppatori esperti che lavoravano su progetti che conoscevano già a memoria. Con l’assistenza dell’AI sono stati circa il 19% più lenti. La parte che ti deve far pensare: erano convinti di essere più veloci (METR, 2025).
Leggilo bene, perché non dice quello che sembra. Non dice “l’AI ti rallenta sempre”. Dice una cosa più sottile: senza un giudice esterno, nemmeno i professionisti sanno valutare il proprio lavoro. La percezione ha preso il posto della misura. Non erano solo esposti agli errori del modello: erano esposti a un’illusione sulla propria produttività.
È la stessa dinamica delle famose “scoperte” AI su problemi matematici aperti (i problemi di Erdős): in diversi casi documentati si sono rivelate non scoperte, ma il recupero di roba già pubblicata da qualche parte. Lo ha fatto notare tra gli altri il matematico Terence Tao, a proposito di alcuni modelli GPT-5.x (the-decoder, 2026). Senza un giudice esterno che certifichi, non c’è modo di distinguere una scoperta da un ripescaggio ben confezionato.
In concreto, cosa fai lunedì mattina
Non ti serve Lean. Non ti servirà mai. Ti serve un riflesso, e questo pezzo te lo lascia in tre mosse:
1. Prima di fidarti di un output AI, cerca il giudice. C’è qualcosa che, fuori dal modello, ti dice sì o no in modo netto? Il codice gira o crasha? Il numero torna o no? Il fatto è verificabile su una fonte indipendente? Se sì, la fiducia è più solida. Se no, sei in territorio probabilistico: bello, plausibile, ma da verificare a mano.
2. Diffida della tua stessa sensazione di velocità. Lo studio METR è una doccia fredda salutare: “mi sembra più veloce” non è “sono più veloce”. Misura, non percepire, almeno sulle cose che contano.
3. Con dati, numeri, citazioni, riferimenti normativi: verifica sempre. Questi sono esattamente i casi in cui il modello inventa con più faccia tosta, e sono anche i casi in cui l’errore ti costa di più. Un giudice esterno lì è d’obbligo, e spesso quel giudice sei tu con una ricerca in più.
La notizia di Fermat è affascinante per la matematica. Ma la lezione è tua: la fiducia in un’AI non si costruisce sulla grandezza del modello o su quanto suona sicuro. Si costruisce sull’esistenza di qualcosa, fuori, che non si può convincere. Trovalo, e sai quando fidarti. Non lo trovi, e allora il giudice tocca a te.
Articoli correlati
- Papà, ma come fa ChatGPT a sapere tutto?
- 100 Milioni di Persone Hanno Letto Questo Post sull’AI. Nessuno Ha Notato l’Errore Più Grande
- Ogni settimana esce “il modello migliore di sempre”. Ho smesso di crederci.
- È uscito Opus 4.8: hanno costruito l’AI che ammette di non sapere
Fonti
- Anthropic — Formalizing Fermat’s Last Theorem (2026)
- Nature — Anthropic AI ‘formalizes’ proof of Fermat’s last theorem (2026)
- Nature — Olympiad-level formal mathematical reasoning with RL / AlphaProof (2025)
- Google DeepMind — AI solves IMO problems at silver-medal level (2024)
- arXiv 2508.03613 — Goedel-Prover-V2, Princeton (2026)
- Simons Foundation — From Trust to Verification: Lean’s Impact on Mathematics (2026)
- METR — Measuring the impact of AI on experienced open-source developer productivity (luglio 2025)
- AI Weekly — Anthropic’s Claude Formalizes Fermat’s Last Theorem in Lean (2026)
- arXiv 2510.01346 — Aristotle / IMO 2025 (2026)
- arXiv 2507.23726 — Seed-Prover / IMO 2025 (2026)
- the-decoder — problemi Erdős e modelli GPT-5.x, commento di Terence Tao (2026)
✍️ Articolo firmato da “La Redazione”: sistema editoriale multi-agente (AI) orchestrato con Claude Code e supervisionato da Luca Cazzaniga · lucacazzaniga.it
Leggi anche