 13 min di lettura
Soldi e velocità sono due leve diverse, e chi le vende le mescola
Stesso modello Luna, strada diversa: cosa muove i costi, cosa muove i tempi e cosa è ancora solo una dichiarazione di OpenAI.
📌 Questo pezzo parte da una promessa (meno costi, risposte quasi istantanee) e la mette alla prova numero per numero. Ti porti a casa un criterio per guardare le tue automazioni, un conto onesto in dollari e una regola per non farti male quando il modello non è sicuro. Dove un dato è solo una dichiarazione di OpenAI, te lo scrivo.
La notizia mi è arrivata con questa promessa: “-90% di costi, 10 volte più veloce”. Due numeri bellissimi, nella stessa riga, per la stessa novità.
Mi sono chiesto come mai stiano insieme così bene. Poi ho fatto la cosa noiosa: ho riaperto le fonti una per una.
Il primo numero, il “-90%”, non l’ho trovato in nessuna fonte che sono riuscito ad aprire: non nella documentazione ufficiale di OpenAI, non nel listino, non negli articoli di stampa. Il comunicato ufficiale, invece, non si apre (te ne parlo tra poco). Finché non lo vedo scritto da qualche parte, per me quel numero non c’è, e l’ho tolto.
Il secondo numero, il “10 volte più veloce”, esiste. Ma sta misurando una cosa diversa da quella che di solito ti fanno immaginare. Ed è qui che il discorso diventa utile, anche se non scrivi una riga di codice.
Riepilogo Articolo - Luca Cazzaniga
Cosa ha lanciato OpenAI, e cosa non è
La novità si chiama Decisions API. Per la documentazione ufficiale di OpenAI è “now generally available”, cioè disponibile a tutti. “API”, se non ti è familiare, è la porta da cui un programma parla con il modello, senza passare dalla chat. Secondo TechCrunch (articolo del 22 ottobre 2026) è arrivata a tutti a fine ottobre, dopo una presentazione in anteprima limitata al developer day del 29 settembre. In mezzo, secondo Unite.AI e LLM Reference, c’è stata una beta pubblica partita il 6 ottobre.
Una nota di trasparenza: la pagina del comunicato ufficiale su openai.com, quando ho provato ad aprirla, mi ha risposto con un errore di accesso, due volte. Per questo mi appoggio alla documentazione e alla pagina prezzi, che invece si aprono e dicono le stesse cose.
Cosa fa? Non scrive testi. Risponde a domande di tre tipi: un sì o no con una probabilità da 0 a 1, una scelta tra più opzioni con un livello di fiducia, un punteggio su una scala. Accetta testo, immagini e dati strutturati, e restituisce risposte “tipizzate”: non un discorso, ma una scheda compilata, come il modulo di un medico con le caselle da spuntare.
Poi c’è il punto che cambia la lettura di tutto. Non è un modello nuovo. Funziona solo con gpt-6-luna, e Nikunj Handa di OpenAI lo dice senza giri di parole a TechCrunch: è “just plain old Luna that gets the job done”. OpenAI ha riconfigurato Luna invece di costruire un modello dedicato.
Un chiarimento sui nomi, perché in giro c’è confusione. La famiglia GPT-6 si compone di tre modelli: Luna, Sol e Astra, secondo la pagina prezzi ufficiale. “GPT-6 pieno” non è il nome di nessun prodotto.
Quindi la novità è una modalità di lavoro, non un modello più piccolo e più furbo. Tienilo a mente, perché da qui in poi separo due leve che il marketing tende a fondere.
Il professore e l’interruttore
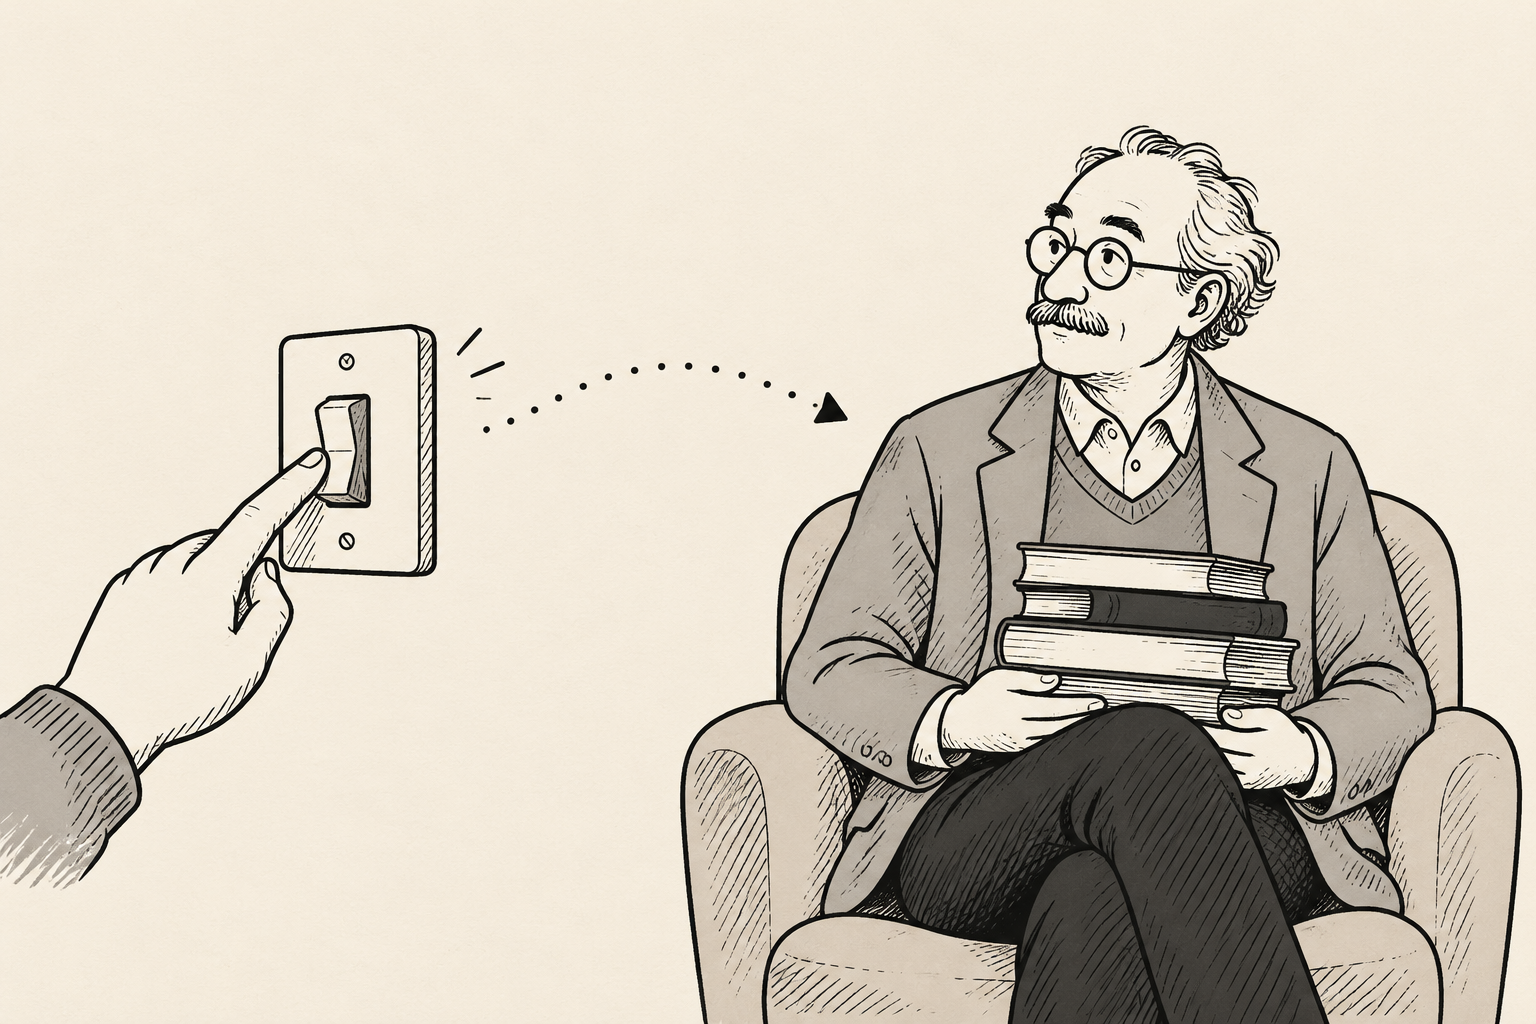
Prima di guardare i numeri, ti serve l’immagine giusta.
Pensa a un’automazione che lavora per te. Per esempio: arrivano email dai clienti, e il sistema deve smistarle. Molti passaggi sono bivi banali: questa email è una richiesta di preventivo, sì o no? Appartiene all’ordine A, B o C? Altri passaggi invece sono ragionamento vero: capire cosa vuole davvero quel cliente e scrivergli una risposta sensata.
I bivi sono interruttori: su o giù. Il ragionamento è un professore: serve quando la domanda è complessa. Il problema è chiamare il professore per accendere la luce.
Attenzione, non ti dico quanta parte di un agente sia fatta di interruttori. Non esiste un dato solido su questo (l’unico che ho trovato è un aneddoto di un singolo agente, e il risparmio veniva da regole fisse, non da un modello piccolo). Quello che ti do è un criterio da applicare alle tue automazioni, non una statistica.
Le due leve: soldi e velocità
Ecco la distinzione che regge tutto il resto.
- Leva A: la taglia del modello. Passare da un modello grande (Sol) a uno piccolo (Luna). Questa leva muove i soldi. La fonte è il listino ufficiale.
- Leva B: il tipo di accesso. Stesso Luna, ma usato tramite la Decisions API invece che tramite l’API generica di OpenAI (la Responses API). Questa leva muove la velocità. La fonte sono le dichiarazioni di OpenAI.
Sono due variabili diverse. Il “10 volte più veloce” riguarda la leva B. Il risparmio, quel poco che c’è, riguarda soprattutto la leva A. Chi ti vende i due numeri insieme sta mescolando le carte.
Leva B, la velocità: cosa dicono i numeri e cosa no
Partiamo dal “10x”. La documentazione di OpenAI lo scrive così: la Decisions API è “about 10x faster than the Responses API”. Il paragone è con la stessa Luna usata in modo generico. Non è un confronto con un modello grande. E OpenAI non pubblica il metodo con cui l’ha misurato.
I numeri assoluti, riportati da TechCrunch come dichiarazione di OpenAI: i tempi di risposta scendono da “uno-tre secondi” a “100, 120, 180 millisecondi”. L’obiettivo dichiarato è arrivare a circa 60 millisecondi. Per capirci: un secondo sono mille millisecondi, quindi stiamo parlando di passare dal tempo di un battito di ciglia lungo a qualcosa che non percepisci.
C’è anche un cliente che lo conferma, Speak: il suo CTO, Andrew Hsu, racconta che il tempo tra un’azione e l’altra è passato da 1,4 secondi a 0,13 secondi. Attenzione però: è un caso di un cliente, non un test indipendente, e l’articolo non dice per quale uso. Non ti racconto che sia per la voce o per il tempo reale, perché nessuna fonte lo dice. Secondo TechCrunch, nel contesto delle dichiarazioni di OpenAI, la velocità è stata “the big unlock” di questa API.
Ora i limiti, che contano quanto i numeri.
- Sono tutte dichiarazioni. Vengono da OpenAI o da un suo cliente. Non ho trovato un solo test indipendente.
- Non ho nessun dato sulla velocità di Sol o di Astra per compiti brevi. Quindi non ti dirò mai che “il modello grande è lento”: non lo so, e nessuna fonte me lo dice. Posso dirti solo che Luna via Decisions API è, per OpenAI, più veloce di Luna via API generica.
- Misuralo sul tuo flusso. Se un giorno hai accesso, prova tu: il tuo caso non è il loro.
Leva A, i soldi: il conto onesto
Ora i soldi. Rifacciamo il conto, con le ipotesi scritte in chiaro.
Ipotesi: 1.000 email al mese. Per ogni email, 500 unità di testo in ingresso e 50 in uscita (le unità, i “token”, sono i pezzetti in cui il modello spezza le parole: spesso più corti di una parola intera). È una stima mia, non un dato di fonte. I prezzi sono quelli del listino ufficiale OpenAI, per milione di unità, in dollari:
- Luna: 0,10 $ in ingresso, 0,50 $ in uscita.
- Sol: 2,00 $ in ingresso, 10,00 $ in uscita.
- Astra: 10,00 $ in ingresso, 50,00 $ in uscita.
La Decisions API con Luna costa 0,10 $ per milione di unità in ingresso, e le unità in uscita non vengono addebitate.
Risultato, per 1.000 email al mese (stima):
- Con Sol: circa 1,50 $ al mese.
- Con Luna nel modo generico: circa 0,075 $.
- Con Luna via Decisions API: circa 0,05 $.
Leggi bene. Da Sol alla Decisions API il rapporto è di circa 30 volte, e suona enorme. Ma la differenza in assoluto è di circa 1,45 dollari al mese. Più o meno un caffè.
E dentro Luna, passare dal modo generico alla Decisions API vale un -33%: da 0,075 a 0,05 dollari. Quindi il risparmio vero viene dal cambio di modello (leva A). La modalità Decisions aggiunge un pezzetto, che per un freelance sono spiccioli.
Dov’è che il costo conta davvero? Quando le chiamate diventano centinaia di migliaia. Per chi ha un’azienda con un flusso enorme, il conto cambia. Per te che smisti le email di uno studio, no. Se qualcuno ti dice che con questa novità “dimezzi la spesa”, chiedigli su quale volume.
Dove la velocità può cambiare qualcosa
Allora a cosa serve, per uno come te, la leva B?
Per una singola email, la differenza tra uno-tre secondi e 100-180 millisecondi non la vedi. Aspetti comunque la risposta in mezzo a un caffè. La differenza si sente in due casi: quando hai tanti bivi in fila, o quando c’è una persona che aspetta una risposta.
Un calcolo illustrativo, e lo marco come tale: è una mia estrapolazione dai numeri dichiarati, non un test. Dieci bivi in sequenza, a parità di modello (Luna): via API generica sono 10-30 secondi, via Decisions API 1-1,8 secondi. Con la prima strada sei in attesa. Con la seconda quasi non te ne accorgi.
Resta condizionale: se i tuoi flussi sono di quel tipo. Non ti dico che le tue automazioni devono diventare in tempo reale. Per molte non serve.
L’idea non è nuova
Mettere un modello piccolo davanti a uno grande, che scelga chi deve lavorare, c’era già nel 2024. Si chiama RouteLLM ed è un lavoro di ricercatori di UC Berkeley. L’abstract dice che i costi si riducono “by over 2 times in certain cases” senza perdere qualità. Sulla pagina del progetto gli autori dichiarano riduzioni di costo oltre l’85% su un test (MT Bench), 45% su un altro (MMLU) e 35% su un terzo (GSM8K), rispetto al solo GPT-4, mantenendo circa il 95% delle prestazioni. Occhio: sono i casi migliori, su test di laboratorio, dichiarati dagli autori. Non una misura sul tuo lavoro.
E c’è un precedente sulla fiducia. Ad agosto 2025 il router automatico di GPT-5 dentro ChatGPT fu giudicato da alcuni utenti “opaque and unreliable”, con il sospetto che dirottasse richieste costose su modelli più economici. OpenAI aggiunse le modalità manuali Auto, Fast e Thinking. Sam Altman disse che “most users will want Auto”.
Un avvertimento onesto: il router di ChatGPT è una funzione per chi usa ChatGPT; la Decisions API è uno strumento per chi costruisce software. Non sono prodotti alla pari. Il paragone lo faccio solo per il tema: scegliere al posto tuo funziona se capisci come sceglie.
E qui la Decisions API ha una differenza (è una mia inferenza dalla documentazione, non una promessa di OpenAI): restituisce la risposta insieme a un livello di fiducia. Chi costruisce può decidere cosa fare nei casi incerti. Non dico “più accurata”, dico più ispezionabile. Sono due cose diverse.
Quando il bivio sembra banale e non lo è
Questo è il rischio vero. Non è che il modello piccolo sbagli sempre. È che sbagli con sicurezza proprio sui casi ambigui: l’email sarcastica, quella a doppio senso, il cliente che scrive “bravi, davvero bravi” dopo che hai consegnato in ritardo.
I dati su Luna non ci sono: OpenAI non pubblica tassi di errore. Ti porto solo un’analogia, e la dichiaro come tale. Uno studio pubblicato ad agosto 2026 ha provato modelli piccoli da 1-2 miliardi di parametri a riconoscere il sarcasmo in 23.448 titoli: senza addestramento specifico collassano su una sola classe, con un’accuratezza massima di 0,54. Con addestramento mirato, uno di loro arriva a un punteggio di 0,96. Non sono modelli di OpenAI e non è Luna: è un campanello d’allarme, non una sentenza.
Cosa dice la documentazione ufficiale per difendersi? Tre cose, tutte pratiche:
- Se le tue categorie non coprono tutti i casi, prevedi un’opzione di ripiego tipo “other”.
- I risultati che non rientrano possono finire in una coda di revisione, dove li guarda una persona.
- Le soglie vanno tarate: OpenAI scrive di usare esempi etichettati della tua applicazione per decidere quando instradare, filtrare o far rivedere.
Non va invece usata per generare oggetti con uno schema proprio, né per chiamare funzioni: per quelli esistono altri strumenti.
Una raccomandazione mia, non della fonte: comincia dai bivi reversibili. Se sbaglia a etichettare un’email e puoi correggerlo in dieci secondi, il rischio è basso. Se sbaglia e parte una risposta al cliente sbagliato, no.
Cosa puoi fare davvero, oggi
Qui devo essere onesto su un limite, e te lo dico prima di venderti qualsiasi cosa.
Leva A (modello giusto per ogni passaggio). Questa la puoi applicare adesso senza scrivere codice. In n8n, lo strumento di automazione di cui parlo spesso (la guida per iniziare è nell’archivio), c’è un nodo chiamato Model Selector. Sceglie al volo tra più modelli collegati in base a regole: la prima regola che corrisponde vince. La documentazione lo indica anche come ripiego in caso di errore e per scegliere il modello più adatto a un compito specifico. È il modo concreto per dire “il modello piccolo ai passaggi banali, quello grande al ragionamento”. Ma ricorda quanto vale: è la leva dei soldi, e abbiamo visto che parliamo di un caffè al mese.
Leva B (la velocità Decisions). Qui non ho buone notizie. Nelle fonti che ho raccolto non c’è nessuna integrazione documentata della Decisions API con n8n, Make o Zapier. Per chi non scrive codice, oggi l’accesso alla modalità veloce non risulta documentato. Non ti faccio intendere che n8n te la regali: non l’ho trovato. Per Make e Zapier non ho nemmeno documentazione sulla scelta del modello per singolo passaggio, quindi non te li indico come strada.
Il valore da portare a casa, per ora, è il criterio. Prendi un foglio e fai questo esercizio.
- Elenca i passaggi di una tua automazione (anche solo quella che hai in testa).
- Accanto a ognuno scrivi I se è un interruttore (sì/no, scegli tra A, B, C) o P se serve il professore (ragionare, scrivere, capire).
- Sugli interruttori chiediti: se sbaglia, cosa succede? Si corregge in fretta? Allora è un candidato. Se no, serve una via d’uscita: un’opzione “altro” e una persona che guarda.
Quando lo strumento arriverà anche per chi non programma, avrai già la mappa pronta.
Cosa mi porto a casa
Tre cose.
Primo: il criterio. Interruttore o professore. Non è una statistica, è una domanda da farti su ogni passaggio.
Secondo: l’ordine di grandezza. Circa 1,50 $ al mese per 1.000 email con un modello grande, contro circa 0,05 $ con la Decisions API: un risparmio di poco più di un dollaro (stima, con ipotesi dichiarate). Il “-90%” non l’ho trovato in nessuna fonte che ho potuto aprire. Se qualcuno te lo propone come motivo per cambiare strumento, hai la risposta.
Terzo: soldi e velocità sono due leve diverse. I soldi vengono dalla taglia del modello. La velocità, per come la racconta OpenAI, viene dalla modalità: stesso Luna, strada diversa. E quella velocità è, per ora, una dichiarazione senza test indipendenti.
La cosa da fare adesso: oggi stesso, fai l’esercizio del foglio su una tua automazione. Dieci minuti. Poi, se hai un flusso con tanti bivi in fila o una persona che aspetta, scrivimi in risposta com’è fatto: è il genere di caso in cui il discorso sulla velocità si misura davvero, e mi piacerebbe sapere se regge.
Luca
Articoli correlati
- N8N: La Guida per iniziare ad Automatizzare il Tuo Lavoro
- Pagheremo l’AI a consumo? Sì, no e dipende da chi sei
- Il garzone digitale: cosa fanno davvero i dots di OpenAI
- E’ Uscito Gemini 3.8. Stare dietro all’AI è diventato un lavoro. Io lo faccio fare all’AI
Fonti
- OpenAI, guida Decisions API (documentazione ufficiale)
- OpenAI, pagina prezzi API (documentazione ufficiale)
- TechCrunch, Tim Fernholz, 22/10/2026
- Unite.AI, 06/10/2026, Decisions API in beta pubblica
- LLM Reference, scheda gpt-6-luna-decisions (agg. 07/10/2026)
- The Decoder, Matthias Bastian, 13/08/2025
- RouteLLM, Ong et al., arXiv 2406.18665 (26/06/2024, v4 23/02/2025)
- Berkeley Sky Lab, pagina progetto RouteLLM, 13/09/2024
- n8n docs, nodo Model Selector
- IIETA ISI, Atmojo et al., 31/08/2026, sarcasmo con piccoli modelli
Fonti: OpenAI documentazione Decisions API (A); OpenAI pagina prezzi (B); TechCrunch, 22/10/2026 (C); The Decoder, 13/08/2025 (D); RouteLLM arXiv 2406.18665 (E); Berkeley Sky Lab, pagina RouteLLM (E2); n8n docs, Model Selector (F); Unite.AI, 06/10/2026 (G); LLM Reference, scheda gpt-6-luna-decisions (H); IIETA ISI, Atmojo et al., 31/08/2026 (I).
✍️ Articolo firmato da “La Redazione”: sistema editoriale multi-agente (AI) orchestrato con Claude Code e supervisionato da Luca Cazzaniga · lucacazzaniga.it
Leggi anche