 12 min di lettura
Il 70% sui partner di ChatGPT non dice quello che pensi
Si parla di corsia preferenziale per i partner di OpenAI. Il numero misura altro, e il traffico dice dove mettere il tuo tempo.
📌 Questo pezzo parte da una notizia con una fonte sola e di parte, e te lo dico subito perché cambia come va letta. Ti porto cosa c’è, cosa manca, e perché la scelta pratica per un creativo indipendente regge anche se quella notizia venisse smentita domani.
C’è un numero che sta girando in queste ore: 70%.
Se lo vedi nel titolo di un’analisi sull’AI, a colpo d’occhio ti viene da leggerlo in un modo solo: i grandi editori partner di OpenAI occupano il 70% delle risposte di ChatGPT, e tu, con il tuo sito o il tuo portfolio, resti fuori dalla porta.
Non è quello che misura. E capire cosa misura davvero è già metà della lezione su come ti stanno vendendo la cosiddetta “SEO per l’AI”.
Facciamo con ordine. Prima cosa è emerso, con tutte le cautele del caso. Poi il 70%. Poi un indizio che arriva dall’università, e che è meno chiaro di quanto sembri. Infine la parte che ti serve lunedì mattina.
Riepilogo Articolo - Luca Cazzaniga
Cosa è emerso (e quanto pesa)
Il 27 ottobre 2026 The Decoder, testata di settore, ha ripreso un’analisi di David Konitzny, ricercatore che si occupa di GEO (la sigla sta per generative engine optimization: sono le tecniche per farsi citare dai motori di risposta come ChatGPT, la cugina della SEO che conosci). Lavora per Peec AI, una società di questo settore.
Secondo l’analisi, dentro ChatGPT i contenuti degli editori partner arrivano al modello come riassunti già pronti (nel testo originale “pre-generated summaries”), mentre le pagine web normali arrivano come frammenti di testo grezzo (“raw text snippets”). Immagina due modi di consegnare un dossier a un collega: ai partner prepari la scheda di sintesi, agli altri allunghi una manciata di ritagli presi al volo da una fotocopiatrice.
Dei tre “motori di notizie” che ChatGPT sembra usare, uno solo compila un campo “provider”: copre 12 editori e 43 domini, tra cui Condé Nast, Hearst, Axel Springer, News Corp, Reuters e AP. E sempre secondo l’analisi, nel prompt (le istruzioni interne che il modello legge prima di risponderti) le voci dei partner compaiono prima dei risultati del web. Il canale non riguarda solo le notizie: copre anche ricette, recensioni di prodotti e guide all’acquisto.
Fin qui il racconto. Adesso le cautele, che non sono una formalità:
- È una fonte sola. The Decoder riprende il post di Konitzny, e scrive “appears to”, sembra.
- È una fonte di parte. L’autore lavora in una società che vende servizi nel settore di cui parla.
- C’è chi contesta un pezzo del quadro. Nei commenti al post qualcuno sostiene che “labrador”, il motore con il campo provider, sia descritto come un indice proprio di ChatGPT e non come contenuto in licenza.
- Al momento in cui scriviamo non abbiamo trovato né una replica di OpenAI né una riproduzione indipendente. Non è una conferma e non è una smentita: è un vuoto.
Per questo in tutto il pezzo troverai “secondo un’analisi” e “sembra”. Non è prudenza di facciata. Un meccanismo così, se fosse vero, sarebbe importante. Ma oggi è un segnale, non una prova.
Il 70%: cosa misura davvero
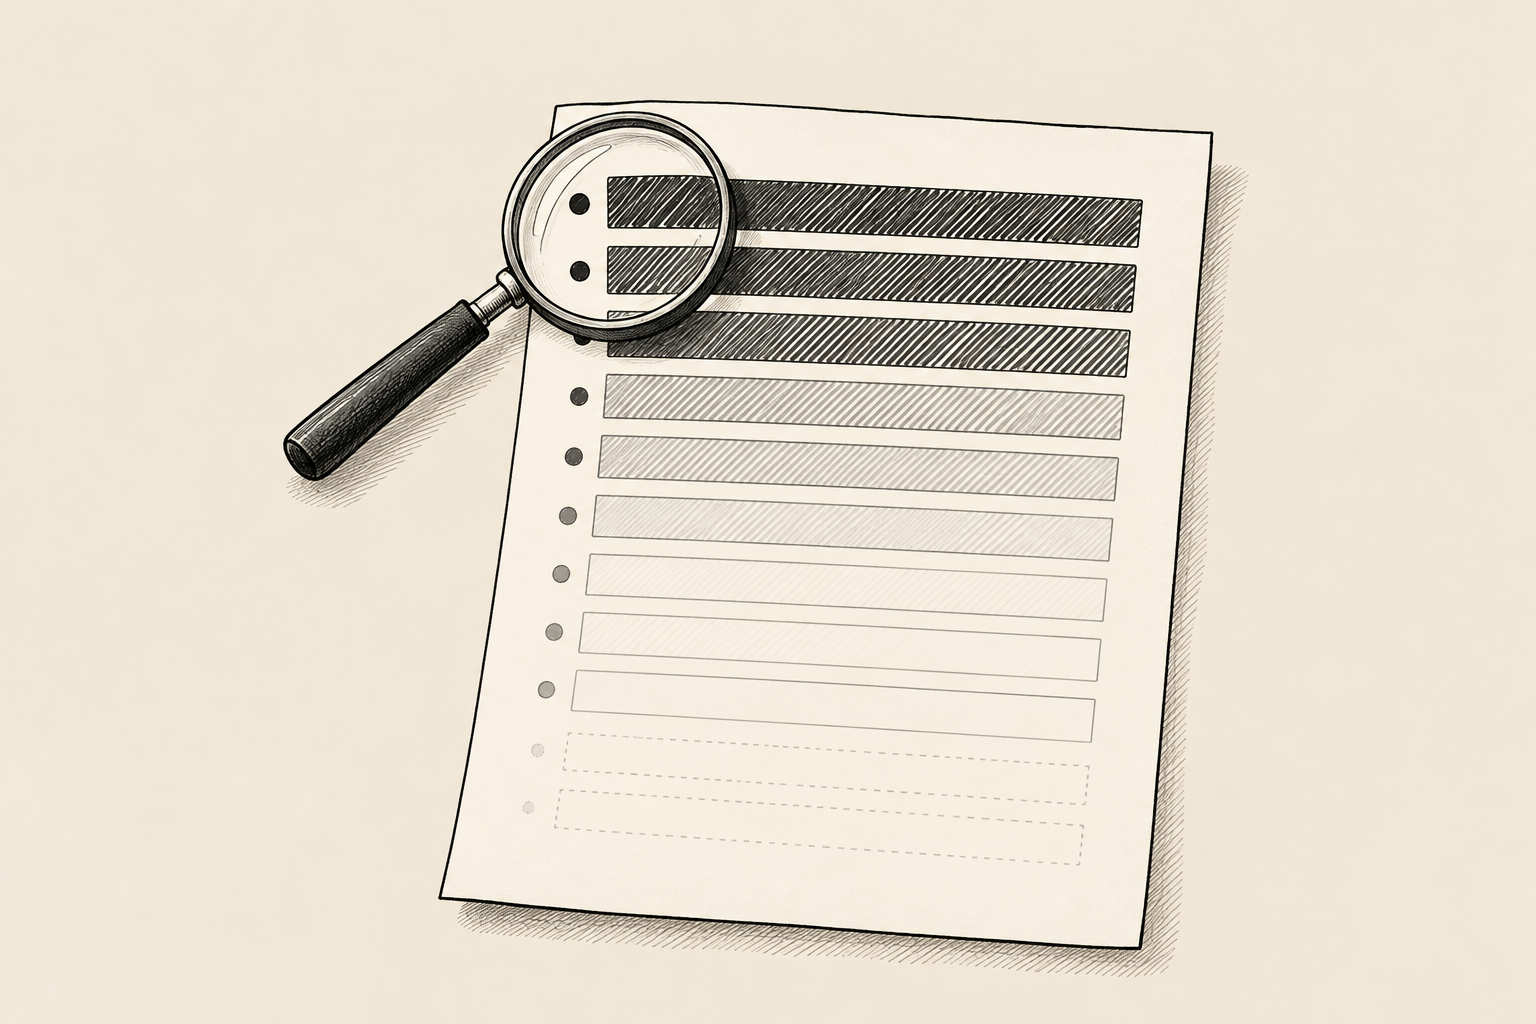
Torniamo al numero. Konitzny ha preso 1.000 riassunti partner di pagine con classifiche (le liste tipo “le 10 migliori…”) e ha guardato quante volte il riassunto nomina le voci della lista, in base alla posizione che occupano.
Il risultato, dal post originale:
- voci in posizione 1-3: nominate nel 70% dei casi
- posizioni 4-6: 41%
- posizioni 7-10: 23%
- da 11 in giù: 12%
Leggilo come lo leggerebbe una persona sveglia: il 70% non dice quanti partner compaiono nelle risposte di ChatGPT. Dice quanto spesso un riassunto partner cita le voci che stanno in cima alla propria lista. È come misurare quante volte, in un riassunto di una classifica dei ristoranti, viene nominato il primo ristorante. Non è una misura di chi vince su ChatGPT.
Non è poco interessante, ma è un’altra cosa. E c’è un secondo limite: periodo, query usate e criteri di selezione non sono stati resi noti. Non esiste, per quello che abbiamo trovato, nessuna fonte che dica “i partner occupano il 70% delle prime risposte”. Se lo senti dire, vale la domanda che dovresti farti con ogni numero sull’AI: chi l’ha misurato, su cosa, e cosa non dice?
Tienila, quella domanda. Ti serve anche per i prossimi due pezzi.
Un indizio ambiguo: Amburgo
L’unico dato che non arriva da una società GEO è uno studio accademico. L’hanno fatto l’Università di Amburgo e il Leibniz Institute for Media Research, e The Decoder lo ha raccontato il 9 novembre 2025. Il lavoro completo è un preprint, cioè una versione non ancora passata dalla revisione di altri esperti.
I ricercatori hanno analizzato oltre 24.000 risposte di ChatGPT su notizie in area tedesca, nell’arco di cinque settimane, confrontando due modi di usarlo: l’interfaccia web (quella che usi tu nel browser) e l’API (il canale che usano i programmatori per collegare ChatGPT ad altri servizi).
Secondo lo studio, come riportato da The Decoder, Welt.de e Bild.de, entrambe di Axel Springer (partner di OpenAI), valgono circa il 13% dei riferimenti nell’interfaccia web e circa il 2% via API. Sul web Welt.de è la prima fonte, via API è la sessantunesima. A prima vista sembra l’indizio che cercavi: stessa domanda, partner favoriti nell’interfaccia che usano tutti.
Poi guardi il resto dello stesso studio. Le emittenti pubbliche valgono il 34,6% delle fonti sul web e il 12,2% via API. Un salto simile, e per loro non risultano accordi noti con OpenAI. Un conto l’ho fatto io, non lo studio: il rapporto è circa 2,8 volte per le emittenti pubbliche, circa 6,5 volte per Axel Springer. Cioè il salto per Springer è più grande, ma l’altro salto esiste comunque.
Cosa ne ricavo, con onestà:
- Il salto tra web e API non è un fenomeno solo da partner. L’interfaccia web sembra premiare in generale le testate grandi e popolari.
- The Decoder non riporta un confronto complessivo tra partner e non partner. L’unico partner discusso è Axel Springer: un caso singolo, non una media.
- Nell’abstract dello studio, popolarità e licenza compaiono affiancate: l’interfaccia web favorisce misure di popolarità mainstream e testate con accordi di licenza. Non vengono separate.
- Ho letto il riassunto iniziale dello studio (l’abstract), non il corpo del lavoro. Quindi non posso dirti né che lo studio dimostri l’effetto della licenza, né che lo escluda.
- OpenAI non ha spiegato le differenze.
Risultato: un indizio ambiguo. Con i dati disponibili, il peso della licenza non si può isolare da quello della popolarità. Se qualcuno leggerà il corpo del lavoro e lo separerà, questa sezione potrebbe cambiare in un senso o nell’altro.
Una nota di contesto, solo come precedente: nel 2024 un documento trapelato ad Adweek descriveva un “Preferred Publisher Program”, con visibilità più evidente per gli editori aderenti. OpenAI rispose che conteneva “a number of mischaracterizations and outdated information”, cioè inesattezze e informazioni superate. Non ne deduco niente sullo stato attuale. Ti dico solo che la domanda non nasce oggi.
Il partner non è un paradiso (e per noi la corsia è quasi vuota)
Facciamo finta, per un attimo, che la corsia preferenziale esista davvero. Conviene stare dentro?
Non è detto. Nel 2024 il Tow Center della Columbia ha testato 200 citazioni di 20 editori: in 153 casi la fonte attribuita da ChatGPT era sbagliata o in parte sbagliata, anche per partner come The Atlantic e il New York Post. ChatGPT ha ammesso di non trovare la fonte solo 7 volte. Sono dati del 2024, quindi vanno presi per quello che sono, ma dicono una cosa semplice: avere un accordo non garantisce di essere citato bene.
E per un creativo italiano la questione è comunque teorica. L’unico partner italiano noto è GEDI (Repubblica, La Stampa): accordo annunciato il 26 settembre 2024, con citazioni, link ed estratti in ChatGPT, più l’uso dei contenuti per l’addestramento. Il 29 novembre 2024 il Garante per la privacy ha inviato a GEDI un avvertimento formale: condividere con OpenAI i dati personali dell’archivio per l’addestramento potrebbe violare il GDPR, il regolamento europeo sulla privacy. Dello stato attuale dell’accordo non ho trovato aggiornamenti affidabili, quindi non ti dico se sia attivo o fermo.
Non ho trovato nemmeno programmi di accesso aperti a creator o piccoli editori. Dico “non ne ho trovati”, non “non ce ne sono”.
La GEO: cosa sappiamo che funzioni (poco)
Ecco la parte che regge la raccomandazione, insieme a quella sul traffico. Chi ti propone di “ottimizzare per farti citare da ChatGPT” ti sta vendendo trucchi. Cosa dicono le misure?
llms.txt. È un file che alcuni consigliano di mettere sul sito per “spiegare” i contenuti alle AI. SE Ranking ha analizzato circa 300.000 domini: il file è presente sul 10,13% e non mostra nessuna correlazione misurabile con la frequenza di citazione. Le parole dello studio:
“doesn’t seem to directly impact AI citation frequency. At least not yet”
Tradotto: per ora non sembra influire direttamente sulla frequenza con cui le AI ti citano.
Cosa conta in laboratorio. In un esperimento controllato (6 modelli, 252.000 prove) pesano soprattutto la rilevanza tematica e la posizione della fonte nell’elenco. Prezzo esplicito e data recente aiutano un po’. La sola formattazione ha un impatto scarso.
Limiti, che ti devo: llms.txt e formattazione sono trucchi specifici, non tutta la GEO. Il primo studio mostra solo che due cose vanno insieme, non che una causi l’altra, e viene da un’azienda che vende strumenti SEO. Il secondo è un test di laboratorio in cui il modello sceglie tra due soli documenti, non è ChatGPT vero, e gli autori hanno legami con Sprinklr. Chi vende GEO e chi ne misura l’efficacia, in questo settore, sono spesso lo stesso tipo di soggetto: lo dico anche di Konitzny, di SEOcrawl e di SE Ranking.
Per tutto il resto: non abbiamo trovato prove indipendenti che i servizi GEO commerciali funzionino. Attenzione a come lo leggi. Non ho detto “non funzionano”. L’assenza di prova non è prova di assenza. Ho detto che chi ti vende il servizio oggi non può mostrarti una verifica terza, e che io, cercando, non l’ho trovata.
Il traffico: dove sta il premio (piccolo)
Qui si decide la cosa pratica. Se una partita vale poco, impiegarci tutto il tuo tempo è una scelta discutibile anche se le regole fossero eque.
Prendi SEOcrawl (studio del 23 ottobre 2026) su 16.661 siti, settembre 2025-agosto 2026 contro l’anno prima:
- i click organici da Google calano del 15,0% (da 3,72 a 3,16 miliardi)
- il sito mediano perde il 20,1%, e il 69% dei siti è in calo
- le sessioni da AI crescono del 44,6% (su 3.949 siti con Google Analytics 4, marzo-agosto 2026 contro lo stesso periodo del 2025)
- ma l’AI porta 1,25 sessioni ogni 100 di Google organico (un anno prima erano 0,70)
- ChatGPT fa l’83,3% delle sessioni da AI
Leggila così: Google si restringe, l’AI cresce in fretta ma parte da quasi niente, e ChatGPT è il canale dominante dentro l’AI. Cautela d’obbligo: SEOcrawl vende strumenti di visibilità sull’AI, il campione è fatto di suoi clienti, e il traffico AI è misurato per difetto (lo dichiarano loro).
Un secondo punto di vista arriva da Chartbeat (dati di marzo 2026, editori): in due anni il traffico da ricerca è calato del 60% per i siti piccoli (1.000-10.000 pagine viste al giorno), del 47% per i medi e del 22% per i grandi. I chatbot AI valgono meno dell’1% delle visite in arrivo da altri siti, anche se quelle da ChatGPT sono cresciute di oltre il 200% tra dicembre 2024 e dicembre 2025. Tienili separati da altri report di Chartbeat con numeri diversi: non si mischiano.
Due limiti da dirti chiaro. Questi sono dati di siti ed editori, non di fotografi, videomaker o copywriter italiani: per i creativi non ho dati specifici. E vengono da fornitori di strumenti, non da un ente neutrale.
Ma il quadro è coerente: chi dipende da Google sta perdendo, chi si butta sull’AI trova un premio ancora piccolo. Dipendere da entrambi è fragile, a prescindere da chi abbia la corsia migliore.
Il controcanto onesto
Sarebbe comodo chiudere con “ChatGPT ti ignora”. Sarebbe falso.
Secondo la documentazione ufficiale di OpenAI, i siti che consentono il bot OAI-SearchBot (il programma che raccoglie le pagine per la ricerca di ChatGPT) possono comparire in ChatGPT search. Quelli che lo bloccano non compaiono nelle risposte, al massimo come link di navigazione. Quindi anche un sito non partner resta citabile.
Citabile non significa alla pari, e non dico che lo sia. Dico che le prove di un trattamento diverso sono, per ora, deboli. Per questo l’igiene minima ha senso: lasciare la porta aperta costa poco. In un pezzo precedente avevo già insistito sul non bloccare i bot di ricerca.
Ma una cosa è non chiudere la porta, un’altra è farne la strategia.
Cosa fare lunedì
La ragione della raccomandazione non è la corsia dei partner. Quella è un possibile aggravante, e se domani venisse smentita non cambierebbe nulla. La ragione sta in due cose che abbiamo visto: il premio è piccolo oggi (traffico), e non abbiamo trovato prove indipendenti che pagare per la GEO funzioni (prove).
Quindi, da solo, senza budget:
- Tieni aperto l’accesso al bot di ricerca. Apri
tuosito.it/robots.txtnel browser (il file che dice ai bot dove possono entrare) e controlla che non ci sia una regolaDisallowper OAI-SearchBot. Cinque minuti. - Usa l’AI come vetrina occasionale, non come piano. Se ti citano, bene. Non fare di quel traffico la voce di entrata su cui costruisci.
- Metti il tempo nel canale che è tuo. Una newsletter con un invito chiaro all’iscrizione in ogni pezzo, una lista di contatti curata, un rapporto diretto con chi ti legge. Nessun algoritmo, nessuna corsia, nessun partner di mezzo. In un altro pezzo ho raccontato perché il web ha smesso di essere nostro e cosa ne ricavo: è lo stesso ragionamento, con altri numeri.
- Applica la domanda del 70% ai numeri che ti propongono: chi l’ha misurato, su cosa, cosa non dice? Prima di pagare un consulente per la GEO, chiedigli quale prova indipendente ha che funzioni.
Non ti vendo la newsletter come bacchetta magica. Richiede costanza e cresce lenta, e a volte per mesi ti sembra di parlare al muro. Ma è l’unico dei tre canali di cui puoi controllare le regole.
E se la corsia dei partner esistesse davvero? Cambierebbe poco per te. Non ci sei dentro, non c’è una porta a cui bussare, e nel test del 2024 anche chi c’era veniva citato male.
Il lavoro per lunedì è uno: scrivi il prossimo pezzo, e metti in fondo un invito chiaro a iscriversi.
Articoli correlati
- Google ha deciso che il tuo sito non servirà più agli utenti. E il suo comunicato ufficiale lo ammette.
- Il giorno in cui il web ha smesso di essere nostro
- Google AI Mode: come ho cambiato il mio modo di fare le ricerche
Fonti
- The Decoder, 27/10/2026: partner content arriva pre-riassunto in ChatGPT
- Post LinkedIn di David Konitzny (Peec AI), fine ottobre 2026
- The Decoder, 09/11/2025: studio Univ. Amburgo e Leibniz Institute
- Schatto-Eckrodt et al., preprint SocArXiv (record LMU, 04/05/2026)
- The Decoder, 12/05/2024: Preferred Publisher Program
- The Decoder, 02/12/2024: Tow Center, Columbia
- Punto Informatico, 26/09/2024: accordo GEDI-OpenAI
- Garante Privacy, 29/11/2024: avvertimento a GEDI
- SEOcrawl, 23/10/2026: 16.661 siti
- Search Engine Journal, 20/11/2025: llms.txt e 300.000 domini
- arXiv 2605.25517, 25/05/2026: What Gets Cited
- Search Engine Journal, 17/03/2026: dati Chartbeat
- OpenAI Developers: documentazione bot
✍️ Articolo firmato da “La Redazione”: sistema editoriale multi-agente (AI) orchestrato con Claude Code e supervisionato da Luca Cazzaniga · lucacazzaniga.it
Leggi anche