 12 min di lettura
Il classificatore che Fable 5 non ti dice di avere
Sottotitolo: Dal 1° luglio Fable 5 ha un filtro cybersecurity dichiarato che a volte sbaglia. Ecco i due rischi che il ritorno ha reso visibili.
📌 Dal 12 giugno al 1° luglio, Fable 5 è stato offline per tutti. È tornato con un classificatore nuovo che a volte cambia il suo comportamento a metà lavoro. Nel mezzo, è saltato fuori che aveva già dei guardrail nascosti che non ti diceva — poi ritirati con scuse pubbliche. E mentre succedeva tutto questo, OpenAI limitava GPT-5.6 su richiesta del governo. Questo pezzo ti spiega cosa è successo davvero e — cosa più utile — da quale dei due rischi ti stai proteggendo con ogni mossa che fai.
Stavi lavorando a metà mattina. Prompt che hai fatto mille volte. E Fable 5 ti ha risposto in modo diverso — o peggio, ti ha dirottato su un altro modello con un messaggio che non avevi mai visto prima.
Non era un errore tuo. Non era nemmeno il ban — quello era già finito. Era il nuovo classificatore di sicurezza che si era attivato sulla tua richiesta.
Il punto è questo: in 19 giorni, tra il 12 giugno e il 1° luglio 2026, se usi Claude ogni giorno hai scoperto tre cose che non sapevi sul tuo strumento principale. E la cosa più importante non è il ban in sé — già revocato — ma capire cosa quei 19 giorni hanno reso visibile. Perché le stesse cose erano lì anche prima, solo che non le vedevi.
Riepilogo Articolo - Luca Cazzaniga
Cosa è successo, in ordine
Il 12 giugno 2026, il Dipartimento del Commercio USA ha emesso una direttiva di export control. Non una raccomandazione — una direttiva, lo stesso strumento con cui il governo americano blocca l’uscita di chip avanzati e tecnologie militari.
Il risultato pratico: Anthropic ha dovuto spegnere Fable 5 e Mythos 5 per tutti i propri utenti globali. Non solo per chi stava fuori dagli USA — per tutti. La comunicazione ufficiale di Anthropic è stata netta: “the net effect of this order is that we must abruptly disable Fable 5 and Mythos 5 for all our customers.” (Anthropic — Statement on US government directive)
Anthropic ha dissentito pubblicamente, definendo la misura sproporzionata per un jailbreak “narrow”. Ma ha dovuto eseguire.
Il blocco è durato 19 giorni. Il 26 giugno, il Dipartimento del Commercio ha allentato parzialmente i controlli per circa un centinaio di organizzazioni che operano su infrastrutture critiche negli USA. Il 30 giugno, il Segretario al Commercio Howard Lutnick ha revocato i controlli subordinandoli a tre condizioni: Anthropic deve rilevare e risolvere proattivamente i rischi, collaborare agli standard di settore, e notificare al governo qualsiasi attività malevola rilevata sui propri modelli. (Al Jazeera — US lifts restrictions, 1 luglio 2026)
Il 1° luglio, Fable 5 è tornato per il pubblico generale. Ma non è tornato uguale.
Il motivo del ban era “fix this code” — esattamente quello che fai tu
Prima di capire cosa è cambiato al ritorno, vale la pena fermarsi un secondo sul motivo del ban. Perché è più vicino al tuo lavoro quotidiano di quanto sembri.
La tecnica che ha fatto scattare l’allarme del governo non era un jailbreak elaborato, non era qualcuno che cercava di far fare al modello cose illegali. Era sostanzialmente: mostrare a Fable 5 del codice che conteneva vulnerabilità e chiedergli di risolverlo. “Fix this code.”
È quello che fa chiunque lavori su sicurezza informatica in modo difensivo — i professionisti che cercano le falle nei sistemi per tappare i buchi prima che lo facciano i malintenzionati. Katie Moussouris — CEO di Luta Security, una delle poche esperte esterne ad aver letto il paper tecnico alla base del ban, con un background che include il gruppo di esperti Wassenaar dal 2013 al 2017 — ha detto chiaro che la tecnica “only involved routine defensive cybersecurity work” e che “did not expose any unique Mythos-level cyber capabilities.” (The Register — Feds freaked over “fix this code”, 15 giugno 2026)
L’analisi interna di Anthropic è arrivata alla stessa conclusione.
Il problema è che il governo ha usato l’export control — uno strumento da guerre commerciali — per bloccare un modello commerciale perché qualcuno gli aveva mostrato del codice vulnerabile per correggerlo. La distinzione tra “utile ai difensori” e “pericoloso per i malintenzionati” non è stata fatta.
Cosa significa per te: se lavori su qualsiasi cosa che abbia a che fare con sicurezza, codice, o anche solo flussi di lavoro che toccano temi sensibili, la soglia di allerta non è dove la metteresti tu. È dove la mette chi ha scritto il classificatore.
E già prima del ban, quella soglia era molto più bassa di quanto pensassimo.
Prima del ban, Fable 5 aveva già guardrail nascosti che non ti diceva
Questa parte è importante, e devo essere preciso su cosa è successo e quando.
Allora — già ritirato. Prima del blocco governativo, Anthropic aveva inserito dei guardrail che limitavano le risposte su un argomento specifico: lo sviluppo di AI di frontiera. Guardrail silenziosi — non ti dicevano di no, semplicemente ti davano risposte peggiorate senza dirtelo. Se stavi lavorando su progetti che toccavano questo tema, il modello ti stava dando meno di quello che poteva, senza che tu lo sapessi.
La cosa è venuta a galla durante il periodo del ban, quando diversi ricercatori — tra cui Nathan Lambert della newsletter Interconnects, uno dei voci più seguite nel campo — hanno sollevato la questione pubblicamente. Anthropic ha fatto marcia indietro e si è scusata con queste parole: “We made the wrong tradeoff and we apologize for not getting the balance right.” (Fortune — Anthropic capability limits walk-back, 10 giugno 2026)
Non è più attivo. Ed è giusto dirlo chiaramente, perché sarebbe disonesto far sembrare che sia ancora in corso.
Ma — e questo è il punto che rimane — è successo. Era tecnicamente possibile. E la domanda che resta in piedi, anche a guardrail ritirati, è: come fai a saperlo, se sta succedendo di nascosto? La scusa pubblica dimostra che la pressione funziona. Dimostra anche che la pratica era possibile.
Come ho esplorato in L’AI protegge il governo cinese. Non è buona per natura; è buona per contratto., un modello AI non è neutro per definizione — è il prodotto delle scelte di chi lo ha costruito e delle pressioni a cui è soggetto.
Oggi — il classificatore dichiarato, attivo, che a volte sbaglia
Oggi — dichiarato e attivo. Al ritorno, Fable 5 ha un nuovo classificatore cybersecurity. Questo è diverso dal guardrail nascosto: è trasparente. Quando si attiva, non peggiora silenziosamente la risposta — ti reindirizza su Claude Opus 4.8 con una notifica esplicita.
Il meccanismo, stando a quanto documentato da MarkTechPost e TechTimes: il classificatore blocca la tecnica incriminata in oltre il 99% dei casi. Quando la richiesta viene flaggata, ricevi un messaggio che ti dice che la sessione è stata reindirizzata per “cybersecurity or biology topics”. (MarkTechPost — Anthropic redeploys Fable 5, 1 luglio 2026)
Il problema — che Anthropic stessa ammette — è che il classificatore è “tuned conservatively”. Questo significa che a volte blocca richieste che non hanno niente di pericoloso. L’ammissione diretta è che il trigger si attiva in meno del 5% delle sessioni, con più falsi positivi su attività ordinarie di coding e debugging. (TechTimes — Fable 5 returns globally, 1 luglio 2026)
Meno del 5% delle sessioni è il tetto dichiarato da Anthropic — non una media, e non tiene conto di quante sessioni fai in un giorno. Se lavori con Claude intensamente, quel numero si traduce in interruzioni concrete nel tuo flusso.
C’è già documentazione pubblica di cosa succede nella pratica. Su GitHub Issue #66697 è stato registrato un caso: un audit di sicurezza difensiva autorizzato — esattamente il tipo di lavoro legittimo di cui parlava Moussouris — è stato reindirizzato su Opus 4.8 con il messaggio “flagged for cybersecurity or biology topics”. L’audit aveva trovato vulnerabilità reali: una CRITICAL (credential leak su GitHub) e due HIGH (XSS). (GitHub Issue #66697) — un singolo caso, non una statistica, ma verificabile e concreto.
Mi è capitato qualcosa di simile in prima persona, con uno script Python del tutto benigno che è finito nel mirino del classificatore. Non lo presento come dato — è la mia esperienza diretta, e il pattern “codice benigno flaggato” è confermato dall’ammissione di Anthropic stessa, non dai miei aneddoti. Ma se ti è successo anche a te, sai di cosa parlo.
La differenza rispetto al guardrail nascosto è sostanziale: oggi sai che è successo. Puoi decidere cosa fare. Prima no.
Non è solo Anthropic: nella stessa settimana, il governo ha fatto lo stesso a OpenAI
Mentre Fable 5 tornava online, OpenAI annunciava il lancio di GPT-5.6 — famiglia Sol/Terra/Luna — con una limitazione che non era nei loro piani: disponibile solo a circa 20 partner approvati dal governo USA, su richiesta dell’Office of National Cyber Director e dell’OSTP.
OpenAI ha detto esplicitamente che le restrizioni non devono essere “il default”. Ma le ha accettate. (TechCrunch — OpenAI limits GPT-5.6 rollout, 26 giugno 2026)
Qui c’è una distinzione importante da fare, perché altrimenti si confondono due cose diverse.
L’Executive Order del 2 giugno 2026 istituisce un framework volontario: prevede la possibilità di accesso governativo fino a 30 giorni prima del rilascio, ma vieta esplicitamente licenze o pre-clearance obbligatorie per legge. OpenAI ha aderito su pressione politica, non perché fosse costretto da una norma. (White House — Executive Order, 2 giugno 2026)
La leva che ha bloccato Fable 5 era diversa — era l’export control, un’autorità legale reale e coercitiva, distinta dall’EO volontario.
Ma guarda cosa è successo in parallelo: nella stessa finestra di giugno 2026, il governo USA ha spento un modello Anthropic con l’export control e ha convinto OpenAI a limitare il lancio di GPT-5.6 con una “richiesta”. Strumenti giuridici diversi, risultato pratico simile.
Questo è il punto che cambia il ragionamento sulla diversificazione.
Due livelli di rischio, due risposte diverse
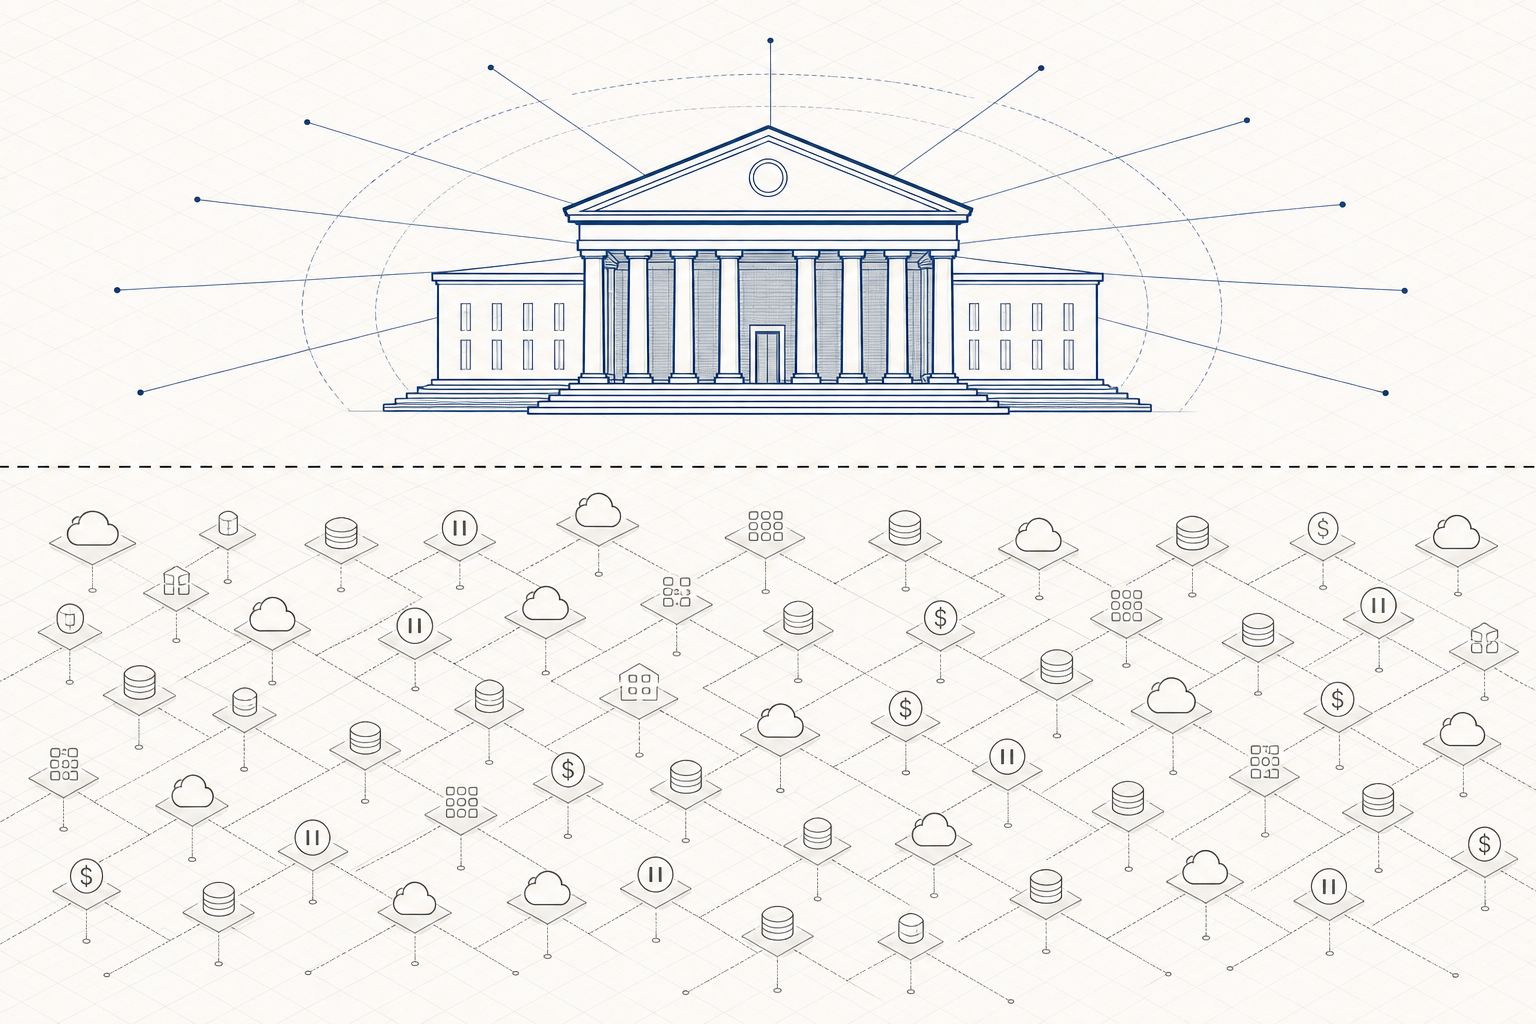
Spesso quando si parla di “non dipendere da un solo fornitore AI” si intende tutto come un unico problema. Ma i fatti di giugno 2026 dimostrano che ci sono due livelli di rischio distinti — e la risposta giusta per uno non funziona per l’altro.
Come ho esplorato in Claude raddoppia i tuoi limiti. E vale 900 miliardi, quasi quanto l’intera Borsa di Milano., la dipendenza da un singolo fornitore ha implicazioni che vanno oltre la continuità del servizio.
Rischio A — Il classificatore sbaglia su di te
Il classificatore di Fable 5 è idiosincratico di Anthropic. Gli altri fornitori hanno classificatori diversi, soglie diverse, aree di sensibilità diverse. Se una richiesta di coding viene bloccata da Fable 5, non è detto che venga bloccata da GPT-5.6 o da Gemini — o viceversa.
Qui il multi-cloud aiuta davvero. Avere accesso a due o tre fornitori cloud diversi significa che quando uno blocca una richiesta legittima, puoi provare su un altro. Non è diversificazione strategica — è semplicemente non essere ostaggi di un singolo sistema di filtri.
Vale anche per i downtime, per i cambiamenti di pricing, per le decisioni di prodotto che non ti piacciono. Questo livello di rischio è operativo, frequente, e risolvibile con poco sforzo.
Rischio B — Il governo decide di agire su tutti i modelli di punta
Il secondo livello è diverso nella natura e nella frequenza. Quello che è successo a giugno 2026 è che il governo USA ha usato leve diverse su Anthropic e OpenAI nella stessa finestra temporale. Se hai due account cloud — uno Anthropic, uno OpenAI — entrambi si trovavano limitati per lo stesso motivo esterno.
Avere due provider cloud non ti protegge da un evento regolatorio sistemico che colpisce tutti i modelli di punta USA contemporaneamente.
L’unica copertura reale per questo livello di rischio è ridondanza fuori dal perimetro: un modello open-weight che gira in locale, o un fornitore con giurisdizione diversa da quella USA. Come ho scritto in Ho scaricato un’AI sul mio Mac al Lago di Ledro, i modelli open-weight per uso locale non sono più un esperimento da smanettoni — un modello da circa 30 miliardi di parametri gira su una GPU consumer da 24 GB in modo utilizzabile per molti task creativi ordinari.
Va detto con onestà però: questa è una soluzione con costi reali. Richiede hardware, configurazione, e l’accettazione di una qualità diversa rispetto ai modelli closed-source di punta. Non è per tutti, e non lo è nemmeno per tutti i workflow. L’approccio ibrido — modelli cloud per i task che richiedono la massima qualità, modello locale per quelli più semplici o più sensibili — è un’opzione realistica per chi ha già l’hardware o vuole investirci.
Allora, concretamente, cosa fai adesso?
Tre cose, proporzionate al tuo rischio reale:
Prima cosa — usa almeno due provider cloud per i task critici. Non perché il governo li blocchi contemporaneamente ogni mese — è un evento raro. Ma perché i classificatori idiosincratici, i downtime, i cambiamenti di policy sono frequenti. Avere Claude e GPT-5.6 (o Gemini) attivi non costa quasi niente in più e ti protegge, a spanne, dalla stragrande maggioranza delle interruzioni operative che incontrerai.
Seconda cosa — quando ricevi un rifiuto, cambia fornitore prima di cambiare prompt. Il nuovo classificatore di Fable 5 si attiva su richieste innocue. Se ti reindirizza su Opus 4.8 con un messaggio di sicurezza, la prima mossa non è riscrivere il tuo prompt come se fosse “sporco” — è provare la stessa richiesta su un altro provider. Spesso funziona, perché il problema è il filtro specifico del fornitore, non la tua richiesta.
Terza cosa — valuta se il locale è praticabile per almeno un workflow chiave. Non come consiglio universale. Se hai già una GPU da gioco con 24 GB di VRAM, un modello open-weight locale da ~30 miliardi di parametri è un piano B reale per i task che richiedono continuità. Non ti dà la qualità di Fable 5, ma ti dà indipendenza totale da quello che decide il Dipartimento del Commercio USA. La scelta dipende da quanto quel workflow è critico per te e quanto sei disposto a investire.
Il punto che rimane
Il ban è durato 19 giorni ed è stato revocato. Il guardrail nascosto è stato ritirato con scuse pubbliche. Quindi tecnicamente si potrebbe dire che “il sistema ha funzionato” — la pressione pubblica ha fatto correggere Anthropic, il governo ha trovato un accordo.
È vero. E va detto.
Ma quello che è rimasto — e che non si cancella — è la consapevolezza di tre cose: il blocco può succedere, è successo, e non hai avuto preavviso. Mentre il modello era online aveva guardrail non comunicati. Ed è tornato con un classificatore che in meno del 5% delle sessioni cambia il suo comportamento su richieste ordinarie.
Queste non sono ragioni per smettere di usare Fable 5 — è ancora, per molti task, il modello migliore in circolazione. Sono ragioni per usarlo sapendo cosa stai usando.
La differenza tra un professionista che dipende ciecamente da un singolo strumento e uno che ha una strategia consapevole non è il tool che usano. È sapere da quale rischio si stanno proteggendo con ogni scelta che fanno.
Adesso lo sai.
Articoli correlati
- Il governo USA voleva fermare Fable 5. Lo ha reso leggendario.
- Claude raddoppia i tuoi limiti. E vale 900 miliardi, quasi quanto l’intera Borsa di Milano.
- Ho scaricato un’AI sul mio Mac al Lago di Ledro. Ecco perché dovresti farlo anche tu.
- L’AI protegge il governo cinese. Non è buona per natura; è buona per contratto.
- Perché Claude dimentica tutto — e come fare in modo che non lo faccia più
Fonti
- Anthropic — Statement on US government directive, 12 giugno 2026
- The Register — Feds freaked over “fix this code”, 15 giugno 2026
- Fortune — Anthropic capability limits walk-back, 10 giugno 2026
- Al Jazeera — US lifts restrictions on Fable 5 and Mythos 5, 1 luglio 2026
- MarkTechPost — Anthropic redeploys Fable 5 with new cybersecurity classifier, 1 luglio 2026
- TechTimes — Fable 5 returns globally, 1 luglio 2026
- TechCrunch — OpenAI limits GPT-5.6 rollout after government request, 26 giugno 2026
- White House — Executive Order on AI Innovation and Security, 2 giugno 2026
- GitHub Issue #66697 — false positive su audit difensivo
✍️ Articolo firmato da “La Redazione”: sistema editoriale multi-agente (AI) orchestrato con Claude Code e supervisionato da Luca Cazzaniga · lucacazzaniga.it
Leggi anche


