 12 min di lettura
Il codice 3D dell’AI funziona quasi sempre. La scena, no.
Riepilogo Articolo - Luca Cazzaniga
Un paper di Maryland e AWS misura la distanza tra un codice che gira e una scena fedele alla foto. E scopre che nessuno dei modelli testati sa giudicarla.
📌 Se lavori con render, mockup di prodotto o scene 3D generate dall’AI, questo pezzo ti interessa più di quanto sembri dal titolo: non parla di un bug esotico, parla del punto esatto in cui, oggi, devi ancora metterci l’occhio tu. Un paper appena uscito ha misurato quel punto con numeri precisi, e i numeri raccontano una storia più interessante del solito “l’AI non capisce lo spazio”.
Primo numero: il codice che un agente AI scrive per ricostruire una scena 3D da una foto funziona quasi sempre. Il 99,5% delle volte produce qualcosa di tecnicamente valido, un oggetto che non rompe nulla, che gira senza errori (lego-anything.com).
Secondo numero, su un aspetto diverso: quando si misura quanto quella scena somiglia davvero, geometricamente, alla foto di partenza, il modello migliore testato, chiamato GPT-6-astra, si ferma al 53,4% in ambienti interni e al 39,6% in ambienti esterni (arXiv:2609.36380; The Decoder).
Il codice “funziona”. La scena non necessariamente “è giusta”. Sono due domande diverse. Attenzione: le fonti non dicono se i due numeri vengono dallo stesso perimetro di modello e scene, quindi non li metto uno contro l’altro come fossero la stessa misura. Qui sta tutto il pezzo.
Cosa fa davvero questo agente (e perché non è un render qualsiasi)
Il progetto si chiama LEGO-Anything. Primo autore Xirui Li, dell’Università del Maryland, lavoro svolto durante un tirocinio in AWS; gli altri nove autori sono tutti di AWS. Il paper è un preprint pubblicato su arXiv il 28 settembre 2026, quindi non ancora passato per la revisione tra pari (arXiv:2609.36380; lego-anything.com).
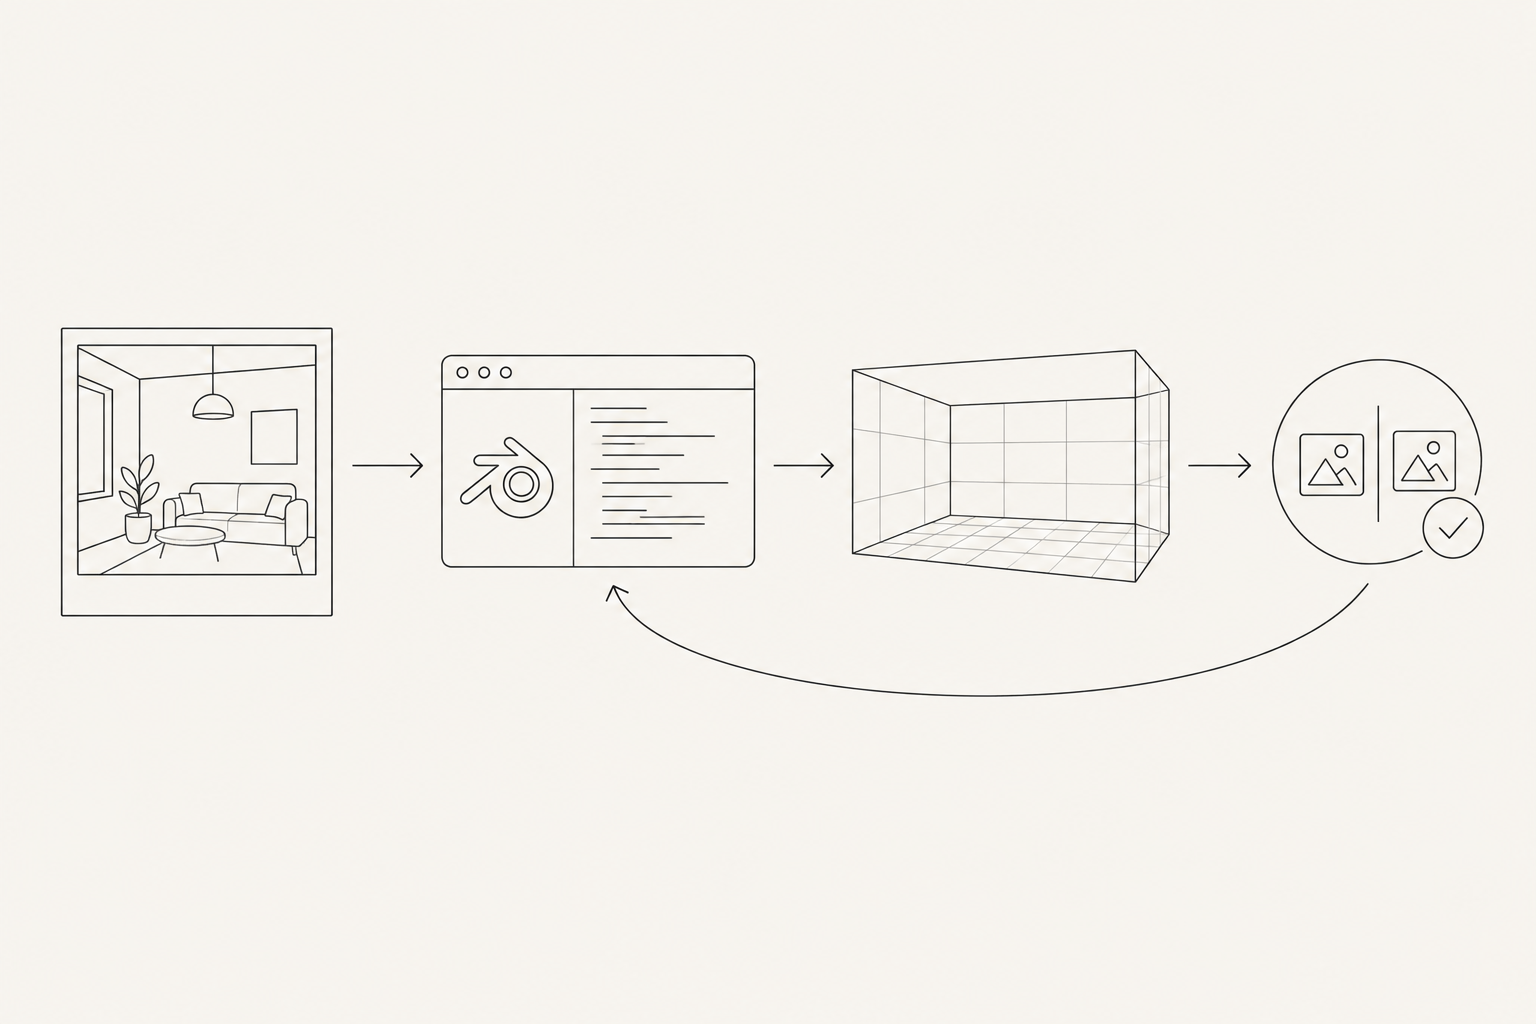
Come funziona, in parole semplici: dai in pasto all’agente una foto di una stanza o di uno spazio esterno. L’agente scrive codice per Blender (il software open source di modellazione 3D) per ricostruire quella scena. Poi fa una cosa che un render tradizionale non fa: guarda il risultato, lo confronta con la foto originale, e corregge il proprio codice. Lo fa più volte, in un ciclo, finché la scena generata non gli sembra abbastanza simile a quella di partenza (arXiv:2609.36380).
È come un apprendista che costruisce un plastico guardando una fotografia: lo monta, confronta con lo scatto, smonta un pezzo che non va, rimonta, confronta di nuovo. La differenza è che qui il confronto finale, “questo plastico assomiglia davvero alla foto?”, lo fa lo stesso apprendista, da solo.
Per misurare quanto bene funziona questo processo, gli stessi autori hanno costruito un banco di prova dedicato, LEGO-Bench: 208 foto prese da 104 scene diverse, sia interni che esterni. Ogni scena ricostruita viene valutata su tre aspetti separati: se l’oggetto generato è tecnicamente valido (validità degli artefatti), se la geometria corrisponde alla realtà (reconstruction), e se l’aspetto visivo renderizzato è simile alla foto (appearance) (arXiv:2609.36380; lego-anything.com).
Tre metri diversi, tre risposte diverse. E qui iniziano i problemi.
I numeri: funziona, ma non benissimo, e molto meno fuori dal laboratorio
Il modello migliore testato, GPT-6-astra, arriva al 53,4% indoor e 39,6% outdoor sulla fedeltà geometrica. Non sono numeri bassissimi, ma nemmeno il “quasi perfetto” che il 99,5% di validità tecnica potrebbe far pensare a chi legge solo il primo dato (arXiv:2609.36380; The Decoder).
Dare più tempo di “pensiero” al modello aiuta, ma non chiude il divario. Su un sottoinsieme specifico del benchmark, chiamato “Office”, far salire il livello di reasoning effort da Low a XHigh, cioè quanto calcolo e quanti passaggi di verifica si lasciano fare al modello prima di rispondere, porta il punteggio dal 32,3% al 61,8% (arXiv:2609.36380; The Decoder). Un salto vero, ma misurato su una fetta ristretta del banco di prova, non sul totale.
Gli ambienti esterni restano i più difficili, a ogni livello di complessità del compito. Sulla fedeltà geometrica: 18,4% per le scene più semplici, 14,2% per quelle medie, 12,7% per quelle più complesse. Sull’aspetto visivo: 25,3%, 22,8%, 22,4% nello stesso ordine (arXiv:2609.36380; lego-anything.com). Più la scena è complicata, meno l’agente ci arriva vicino, e questo vale di più fuori che dentro casa.
Gli stessi autori lo scrivono senza girarci intorno:
Una validità degli artefatti alta lascia comunque divari sostanziali nella fedeltà geometrica e visiva, e le scene outdoor sono più difficili a ogni livello di complessità.
Tradotto: il codice gira, l’oggetto 3D esiste, ma non vuol dire che sia quello giusto.
Il cuore del problema: nessuno dei modelli testati sa giudicare bene la propria geometria (né quella di un altro)
Qui arriva la parte che rende questo paper diverso dal solito articolo “l’AI non capisce lo spazio”.
Gli autori individuano tre problemi ricorrenti nel processo: una partenza debole (la prima bozza della scena parte già storta), correzioni che durante il ciclo di modifica peggiorano invece di migliorare, e un’autovalutazione poco affidabile (arXiv:2609.36380). È il terzo quello che vale la pena fermarsi a guardare.
Quando si chiede all’agente di giudicare da solo quanto la propria scena corrisponde alla geometria reale, i suoi giudizi coincidono con il riferimento usato dal paper solo nel 45,8% dei casi sulla geometria, e nel 62,2% dei casi sull’aspetto visivo. Fin qui potrebbe sembrare il classico caso dell’allievo che si dà un voto più alto di quello che merita. Ma ecco il dato che cambia la lettura: quando a giudicare la stessa scena è un modello diverso, non quello che l’ha generata, l’accordo è 45,4% sulla geometria e 63,9% sull’aspetto (arXiv:2609.36380). Praticamente identico al primo.
Fermati un attimo su questo. Se il problema fosse “l’agente si illude giudicando il proprio lavoro”, ci aspetteremmo che un giudice esterno faccia molto meglio. Non succede. Significa che il problema non è l’autostima del modello: è che nessuno dei modelli testati nel paper, giudicando se stesso o un collega, sa valutare bene se una ricostruzione 3D è geometricamente corretta. Non è un bias di autovalutazione, è un deficit di giudizio condiviso.
Un altro numero lo conferma: l’autogiudizio batte la media degli altri cinque giudici automatici solo per 3 dei 6 modelli testati come costruttori sulla geometria e per 2 su 6 sull’aspetto (arXiv:2609.36380). Non è né molto peggio né molto meglio di un giudice esterno sullo stesso identico compito. È come se chiedessi a cinque persone diverse, tutte competenti nella stessa materia, di valutare se un plastico assomiglia alla foto di riferimento, e tutte e cinque sbagliassero più o meno nella stessa misura. Il problema non è chi guarda: è cosa gli si chiede di vedere.
The Decoder sintetizza questo dato con una formula che vale la pena riportare con precisione: quando giudicano la geometria, i modelli si comportano vicino al livello del caso, anche quando valutano le proprie scene (The Decoder). È la sintesi di The Decoder, e la teniamo così com’è: non “cieco”, non “lancio di moneta”, ma vicino al caso.
A questo punto gli autori provano una terza via, diversa sia dal “fidati dell’agente” sia dal “serve sempre un umano”: sostituire il giudizio del modello con misure automatiche esterne. Il sistema si chiama LEGO-Plugin e usa tre strumenti specializzati: VGGT per ricostruire scena e posizione della camera, SAM 3 per isolare le regioni degli oggetti, Depth Anything V2 per stimare la profondità relativa (arXiv:2609.36380).
I risultati sono interessanti proprio perché non raccontano una vittoria netta. Sui modelli più deboli, le misure automatiche provate nel paper portano guadagni relativi fino al 62,7% (circa 7-8 punti percentuali in valore assoluto). Sul modello migliore, GPT-6-astra, il guadagno è di appena il 2,1% (arXiv:2609.36380; The Decoder). Il paper non isola la causa esatta di questo divario: non dice se il collo di bottiglia residuo sia ancora il giudizio, la qualità della ricostruzione di partenza, o un limite delle misure esterne stesse. Quello che i numeri dicono con certezza è questo: proprio dove la generazione è più sofisticata, uno strumento automatico esterno non chiude ancora il divario.
Non è un caso isolato: il ragionamento spaziale “da fuori” è il punto debole ricorrente
Se ti sembra un problema molto specifico di un singolo paper, due benchmark indipendenti, che non misurano lo stesso compito ma puntano nella stessa direzione, suggeriscono che non lo è.
EASI, uno studio che valuta modelli multimodali su otto benchmark diversi e oltre 10 miliardi di token analizzati, scrive che GPT-5 “mostra una forza senza precedenti nell’intelligenza spaziale, ma resta comunque significativamente indietro rispetto alle prestazioni umane su un ampio spettro di compiti” (arXiv:2508.13142).
OmniSpatial, un altro benchmark indipendente, misura i punteggi complessivi di più modelli: o3 al 56,33%, Gemini-2.5-Pro al 55,19%, GPT-4.1 al 51,78%, GPT-4o al 47,81%, Claude-3.7-Sonnet al 47,53%. Gli umani, sullo stesso test, arrivano al 92,63%: un divario di oltre 30 punti (arXiv:2506.03135v3).
Il dettaglio che conta di più per questo pezzo è nelle sottocategorie di OmniSpatial. Il ragionamento geometrico (circa un quarto o un terzo, tra 25,48% e 34,84%) e la prospettiva allocentrica, cioè capire una scena “da fuori”, da un punto di vista che non è il proprio (tra 36,06% e 48,40%), sono molto più deboli del ragionamento dinamico (57,57%-71,89%) e della prospettiva egocentrica, guardare dal proprio punto di vista (70,98%-77,06%) (arXiv:2506.03135v3).
EASI e OmniSpatial non misurano lo stesso compito di LEGO-Anything: fanno domande e risposte su immagini, non confrontano un render con una foto, e i loro modelli testati (GPT-5, o3, Gemini-2.5, Claude-3.7) sono di una generazione precedente a GPT-6-astra, il modello migliore del paper LEGO-Anything. Non sono quindi una prova diretta della causa del problema misurato da LEGO-Anything, né un confronto diretto modello per modello. Sono un indizio convergente: la categoria di ragionamento più debole nei modelli multimodali in generale è proprio quella “da fuori”, allocentrica, geometrica, la stessa famiglia di giudizio che serve per dire se una scena 3D è corretta, e questo permette di dire che è un limite ricorrente in più studi indipendenti, niente di più (arXiv:2508.13142; arXiv:2506.03135v3).
In breve: il problema non è che l’agente si illude guardando il proprio lavoro. È un deficit di giudizio spaziale più ampio, condiviso da chi genera e da chi dovrebbe controllare.
Il risvolto pratico: dove lo incontri già, e cosa fare
Qui bisogna essere precisi su una cosa: le fonti che seguono parlano di generatori image-to-3D e text-to-3D commerciali, strumenti che producono mesh (il “tessuto” di triangoli che forma una superficie 3D) per stampa 3D o modellazione da planimetrie, in formato STL. Sono una famiglia di tecnologia diversa da LEGO-Anything, che è un agente che scrive codice Blender. Il problema di fondo, “l’output AI 3D non è automaticamente fedele alla realtà”, è analogo, non lo stesso fenomeno misurato dallo stesso benchmark.
RapidDirect, un’azienda che vende servizi di manifattura (quindi con un interesse commerciale dichiarato: vende anche un proprio report di verifica), scrive che le mesh generate dall’AI “richiedono spesso riparazioni per bordi non-manifold, auto-intersezioni, pareti troppo sottili” (RapidDirect). In parole semplici: il modello 3D che l’AI ti dà in output spesso ha “buchi” o incroci di superfici che un software di stampa non sa gestire, e serve ripararli a mano prima di poterli usare davvero.
Questi strumenti, aggiunge RapidDirect, non conoscono tolleranze e accoppiamenti dimensionali: serve una verifica di producibilità (DFM, Design for Manufacturability) prima di produrre qualsiasi cosa (RapidDirect).
Monaverse, che vende invece strumenti di modellazione da planimetrie (altro interesse commerciale da dichiarare), lo dice con una frase diretta:
Uno strumento text-to-3D non sa che il tuo soggiorno è largo 14 piedi (circa 4 metri e 30).
Tradotto: il modello non conosce le misure reali del tuo spazio, le inventa in modo plausibile ma non verificato. E quando ruoti la geometria generata, emergono spesso bordi incoerenti e retri vuoti, superfici che da un lato sembrano finite e dall’altro sono semplicemente assenti (Monaverse).
Il consiglio di chi vende questi strumenti è di usarli per l’esplorazione di un concept o per una mood board, non per i deliverable finali: un render impreciso crea responsabilità professionale concreta al momento dell’installazione reale, quando le misure sbagliate diventano un problema fisico e non più solo visivo (Monaverse).
RapidDirect e Monaverse vendono due tecnologie diverse (manifattura contro modellazione da planimetrie), ma condividono lo stesso incentivo commerciale: convincerti che l’output grezzo dell’AI non basta e che serve il loro servizio. Non è una conferma indipendente in senso scientifico. Resta però un indizio di buon senso operativo condiviso da due fornitori diversi: verifica da più angolazioni, usa misure di scala note prima di fidarti dell’output (RapidDirect; Monaverse).
Cosa portare a casa, concretamente
Se usi l’AI per mockup di prodotto, still life, render d’interni o scene virtuali, oggi questi strumenti sono generatori rapidi di semilavorati spaziali. Non sono un controllo qualità, e questo pezzo lo mostra per tre vie diverse.
Primo: nessuno dei modelli testati, né l’agente che valuta se stesso né un altro modello interrogato come giudice, sa dire in modo affidabile se la geometria di una scena 3D corrisponde alla realtà. È una misura: giudicando la propria geometria, l’agente non fa meglio di un altro modello (45,8% contro 45,4%), e The Decoder lo sintetizza come “vicino al caso”.
Secondo: la via che il paper stesso propone per aggiustarlo, sostituire il giudizio con misure automatiche esterne, funziona bene sui modelli più deboli e quasi per niente sul modello più avanzato (+2,1%). Proprio dove la generazione è più sofisticata, le misure automatiche provate nel paper non chiudono il divario.
Terzo: due benchmark indipendenti indicano che il tipo di ragionamento spaziale più debole nei modelli multimodali in generale è proprio quello “da fuori”, allocentrico e geometrico. Non è un problema isolato di questo paper.
Per te, nella pratica, questo si traduce in tre controlli da fare prima di consegnare o produrre qualsiasi cosa generata in 3D: guarda la scena da più angoli, non da uno solo; confronta con almeno una misura nota di riferimento (una porta, un piano di lavoro, qualsiasi cosa di cui conosci la dimensione reale); controlla i bordi e i retri degli oggetti, dove gli errori di ricostruzione si nascondono più spesso.
Non perché serva sempre un umano per principio. Perché oggi, sui modelli più avanzati, né il modello né gli strumenti di misura automatica provati nel paper chiudono da soli questo divario. Il righello, per ora, lo tieni in mano tu.
Articoli correlati
- Perché il Loop Engineering “è una cagata pazzesca”
- Agenti AI: cosa sono, che tipi esistono, dove usarli
- Oltre l’80% del codice di Anthropic non lo scrive più un umano
- AI Act e fotografia immobiliare: la guida a cosa dichiarare e cosa no
Fonti
- LEGO-Anything: Coding Agents for 3D Scene Reconstruction, arXiv, 28 settembre 2026
- lego-anything.com, pagina progetto, Xirui Li / Univ. Maryland + AWS
- The Decoder, “AI agents build 3D scenes from photos but have no idea if they got it right”, Jonathan Kemper, 3 ottobre 2026
- Holistic Evaluation of Multimodal LLMs on Spatial Intelligence (EASI), arXiv, v5 30 dicembre 2025
- OmniSpatial, arXiv, v3 28 febbraio 2026
- RapidDirect, “Best 6 Image-to-3D AI Generators 2026”, Violet Chan, 3 luglio 2026 (agg. 14 luglio)
- Monaverse, “Text to 3D Model AI: A Designer’s Honest Guide”, Justin Melillo, 1 luglio 2026
✍️ Articolo firmato da “La Redazione”: sistema editoriale multi-agente (AI) orchestrato con Claude Code e supervisionato da Luca Cazzaniga · lucacazzaniga.it
Leggi anche