 14 min di lettura
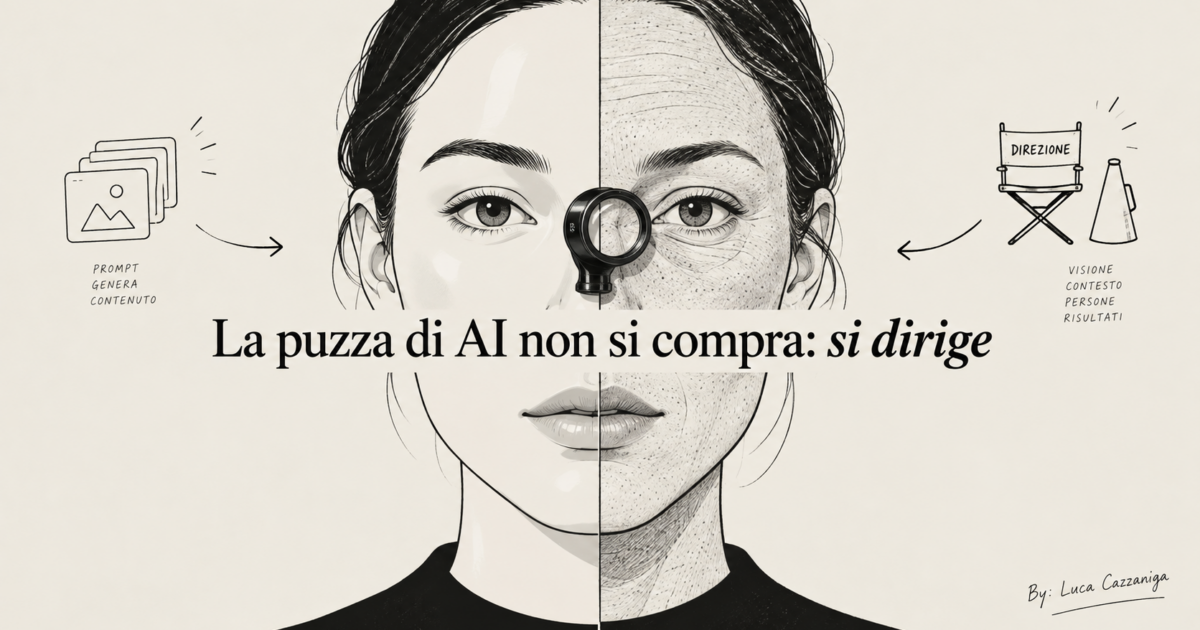
La puzza di AI non si compra: si dirige
Magnific One promette di toglierla, ma test di terzi non ne ho trovati. Cinque leve valide con qualsiasi strumento.
📌 Questo pezzo parte da una notizia (Magnific One, lanciato l’8 ottobre 2026) ma non è la recensione di un tool: nessuno lo ha testato in modo indipendente, o almeno non l’ho trovato. Ti porto cinque leve per rendere un’immagine AI più credibile, dichiarando per ognuna cosa è documentato e cosa no. E ti dico subito una cosa: migliorare l’immagine non vuol dire nascondere che è AI.
Lo dico spesso, in modo brutale, quando vedo un’immagine generata che ha quella pelle da bambola: “non sei un genio tu, è il modello che fa schifo”.
È una battuta. Se generi immagini e il risultato ha quell’aria lucida e perfetta che si riconosce a un chilometro, non hai sbagliato niente. Hai preso quello che lo strumento ti dà di default. Il problema, semmai, è che il default ha un’estetica sua, e non è la tua.
Questa settimana un vendor ha detto la stessa cosa in forma commerciale. E ha cominciato a vendere la soluzione.
Riepilogo Articolo - Luca Cazzaniga
Un vendor ha messo un nome al difetto
L’8 ottobre 2026 Magnific ha lanciato Magnific One, un generatore di immagini che, nelle parole di VentureBeat, promette di evitare l'”AI look” e di applicare in automatico il brand kit (l’insieme di colori, stili ed esempi di un marchio). La diagnosi, però, è quella dell’azienda: parla di una “synthetic sheen”, una patina sintetica, e di cibi e prodotti che vengono “voluptuous”, cioè più succosi e pieni, rispetto ai loro equivalenti reali.
Traduzione da collega: il problema non è più la risoluzione. Le immagini sono nitide. Il problema è che sono troppo belle in modo sospetto.
Ora, guarda dall’altra parte. Midjourney V8.2 è il modello predefinito dal 24 luglio 2026 e le note di rilascio lo descrivono come più “creative, bold, sophisticated, edgy”. Cioè: creativo, audace, sofisticato, un po’ tagliente. È una scelta di prodotto che spinge sull’estetica, non sul realismo neutro.
Quindi niente “il mercato sta andando verso il realismo”. Abbiamo almeno un vendor che dice “togliamo il look AI” e un altro che per default spinge nella direzione opposta. Non è un trend unanime. Sono due idee diverse di chi debba decidere l’aspetto di un’immagine.
Ti dico anche da che parte sto io, per trasparenza: uso Magnific come motore di generazione in alcune mie skill di lavoro. Quindi non sono neutrale sul marchio. Per questo ti racconto cosa è verificato e cosa no.
Qualche dettaglio di servizio, il minimo. Le immagini costano crediti: 180 per High 2K, 250 per High 4K, 600 per Max 2K, 1.000 per Max 4K. VentureBeat stima un costo di circa 0,12-0,73 dollari a immagine con l’uso pieno dei crediti annuali, tasse escluse. Non ti do prezzi in euro perché non li ho verificati.
Cosa sappiamo davvero di Magnific One (poco)
Qui bisogna essere onesti, perché è il genere di notizia che fa venire voglia di scrivere “rivoluzione”. Non lo farò.
Il win rate. Magnific dichiara un tasso di preferenza di circa il 68,5% in un confronto alla cieca. Ma è un test privato, e VentureBeat lo etichetta come non verificato in modo indipendente: risultati, voti e metodologia non sono stati pubblicati. Un numero senza metodo è una promessa, non un dato.
Il motore. Il portavoce di Magnific dice che il sistema è “powered by GPT-Image-2”, con modifiche successive all’addestramento. La FAQ dell’azienda, invece, risponde “Nothing was trained”. Le due frasi non stanno insieme, la contraddizione l’ha notata VentureBeat e l’azienda non l’ha risolta. La mia lettura: quello che Magnific vende non è il motore, è la direzione che ci mette sopra. Come un direttore della fotografia che lavora con la tua stessa macchina.
I test. Non ne ho trovati. Creative AI News scrive esplicitamente di non aver fatto una prova diretta, e due ricerche mie in rete il 16 ottobre non restituiscono recensioni né confronti prima/dopo. Attenzione alla formula: non dico che non esistano, dico che non li ho trovati.
Un contesto, senza dargli peso: Freepik si è rinominata Magnific il 28 aprile 2026 (Tech.eu), e l’azienda dichiara oltre un milione di abbonati paganti. Dichiara, appunto.
Perché ti dico tutto questo? Perché la lezione di questo articolo non dipende dal comprare Magnific One. Se funziona come promette, bene. Se non funziona, le cose che trovi sotto restano valide.
Perché l’AI “puzza”: cosa si vede e cosa si sa
Prima di arrivare alle leve, un confine netto.
Cosa si vede è esperienza di chi usa questi strumenti ogni giorno, io compreso: la pelle troppo liscia, la luce uniforme che non viene da nessuna parte, l’assenza di grana. Questa è osservazione, non misura.
Cosa si sa è molto meno. Nessuna fonte che ho trovato dimostra le cause di questi difetti nei generatori commerciali. Quello che c’è sono indizi, che arrivano da studi su altri compiti e che puntano nella stessa direzione. Te li elenco con il limite di ognuno.
- Il ritocco facciale. Un preprint (uno studio non ancora passato per la revisione di altri ricercatori) dedicato al ritocco, BeautyGRPO, dice che i modelli di editing generali possono produrre una texture “oily or plastic-like” e un aspetto “unnaturally glossy, synthetic”, mentre quelli di ritocco specializzati possono mostrare un “excessive smoothing that erases skin texture”. Gli autori hanno costruito un archivio di 10.000 coppie di preferenze che valuta separatamente levigatura, imperfezioni, texture, nitidezza e identità. È la fonte più diretta che ho trovato sulla pelle plastica, ma parla di ritocco facciale, non di generazione da zero.
- I pori persi per strada. Un altro preprint, DreamMakeup, spiega che una certa tecnica di modifica delle immagini può non conservare la texture fine della pelle (pori, micro-imperfezioni), con il risultato di una pelle innaturale, plastica. Gli autori la descrivono come un problema noto nella comunità di Stable Diffusion. Anche qui: editing, non generazione.
- Più coerente, meno texture. In un modello per ingrandire le immagini, ottimizzare solo sulla preferenza umana ha dato immagini “more coherent but less clear and less textured”. Con un criterio percettivo ed estetico combinato la texture è tornata. Altro compito, altro preprint, indizio indiretto.
- La convergenza. Uno studio presentato a CVPR 2026, Taming Preference Mode Collapse, descrive come i modelli allineati alle preferenze possano convergere su risultati ristretti: stili “monolithic” e sovraesposizione diffusa. Parla di stili ed esposizione, non di pelle.
Ti propongo un’ipotesi, e la chiamo ipotesi: è plausibile che, se un modello viene addestrato a produrre ciò che le persone di solito preferiscono, finisca per premiare anche l’aspetto liscio e pulito. Se fosse così, in parte il difetto nascerebbe dai nostri gusti. Ma nessuna delle fonti sopra lo dimostra: parlano di ingrandimento, ritocco, stili ed esposizione. Prendila come una domanda, non come una conclusione.
La buona notizia è che la parte pratica non dipende dalla causa. Puoi lavorare sul risultato anche senza sapere perché il difetto c’è.
Credibilità e trasparenza sono due leve diverse
Qui devo fermarmi un momento, perché è il punto su cui è più facile fare confusione.
L’idea “togli la plastica e nessuno si accorge che è AI” è seducente. Non la sostengo, e le fonti non la sostengono. Quello che dicono sulla fiducia riguarda soprattutto il sapere che un contenuto è AI, cioè la trasparenza, non quanto l’immagine sembra plastica.
Due esempi.
Guess su Vogue US, agosto 2025. Una doppia pagina con una modella generata dallo studio Seraphinne Vallora, con l’indicazione in piccolo “Produced by Seraphinne Vallora on AI”. Un video su TikTok di @lala4an ha superato i 2 milioni di visualizzazioni, e le critiche, come le riporta ContentGrip, puntavano a pelle impeccabile e simmetria inumana. Però: è una reazione all’AI e a un ideale di bellezza irreale. Non è una prova che la plastica visibile faccia perdere fiducia, né che una versione meno liscia avrebbe evitato le polemiche. Non ci sono dati su fiducia o vendite.
Huffer, Nuova Zelanda, giugno 2026. Alcuni modelli accusano il marchio di averli ricreati con l’AI. La direttrice nega: “No faces of our models have been changed other than in normal computer-assisted design”. Resta un caso ambiguo. Ma B&T riporta la fotografa Mia Borg, secondo cui senza trasparenza i brand “risk losing customers”, e Aaron Francis, che avverte che puntare molto sull’AI fa rischiare che i consumatori mettano in dubbio l’autenticità del brand. La leva, qui, è dire come si lavora.
E gli studi? Pochi e piccoli, e riguardano la disclosure, non il look.
- Uno studio sottoposto a revisione, sul Journal of Consumer Marketing (2025, 444 partecipanti), trova che dichiarare che un contenuto è generato con AI indebolisce l’effetto dell’antropomorfismo (la tendenza a percepire qualcosa come “umano”) sulla presenza sociale percepita. Ma gli scenari sono chatbot e poster pubblicitari, non foto di prodotto.
- Un piccolo studio (199 adulti, 2025, poster studentesco) non trova penalità nella maggior parte delle categorie, tranne l’abbigliamento con disclosure.
- I sondaggi di Canva, Net Conversion e Harris/4As/Infillion indicano un calo di fiducia verso gli annunci AI. Sono ricerche di parte: vanno lette come tali.
Cosa ne ricavo? Tre cose, e le metto in fila perché non si mescolino.
- Non esiste uno studio solido sulle foto, e l’effetto dipende dalla categoria.
- Dichiarare l’uso dell’AI può pesare sulla percezione. Questo non autorizza a ometterlo. La tensione c’è, la dichiaro, e la risolvo dalla parte della trasparenza.
- Le cinque leve che seguono servono a fare immagini migliori e più coerenti. Non a far sparire l’origine. La disclosure resta una scelta separata, e non si delega al look.
(Il caso McDonald’s Paesi Bassi, lo spot natalizio AI ritirato a dicembre 2025 dopo le critiche, lo cito solo per completezza: è un video, non una prova sull’effetto plastica nelle foto.)
Cinque leve per un’immagine più credibile
Non sono trucchi. Sono le stesse scelte che fa un fotografo o un art director. Per ogni leva ti dico quanto è documentata.
Leva 1: dirigi la scena come un direttore della fotografia
Google, nella guida per Nano Banana Pro (20 novembre 2025, firmata da una product manager di DeepMind), consiglia di dirigere la scena “like a cinematographer”, come un direttore della fotografia. Gli esempi: “A low-angle shot with a shallow depth of field (f/1.8)” e “Golden hour backlighting creating long shadows”.
Cosa significa in pratica? Che non scrivi “una donna in un caffè”. Scrivi da dove guardi (dal basso, dall’alto), quanto è sfocato lo sfondo, e da dove arriva la luce. Una luce che ha una sorgente riconoscibile (il sole basso, una finestra) è già meno “da catalogo”.
La stessa guida dice che puoi intervenire anche dopo la generazione su angolo, fuoco e color grading (la correzione dei colori, quella che fai in Lightroom).
Limite onesto: la guida di Google non parla di grana, di emulazione della pellicola né di texture della pelle. Quindi per la pelle questa fonte non ti aiuta.
Se vuoi approfondire la mia storia con questo modello, ne parlo in Rivoluzione nel Photo Editing: Come Integrare Nano Banana direttamente in Photoshop.
Leva 2: usa il vocabolario del fotografo
Una precisazione prima: questa fonte riguarda Imagen 3, un altro modello di Google, non Nano Banana. La guida di Vertex AI elenca i modificatori fotografici che influenzano il risultato: lenti (35mm, 50mm, fisheye, grandangolo, macro), tipo di luce (naturale, drammatica, calda, fredda), pellicola (bianco e nero, polaroid).
Dà anche delle focali per soggetto: ritratti 24-35mm, food e piccoli soggetti in macro 60-105mm, sport e fauna 100-400mm, paesaggi e astrofotografia 10-24mm. Sono “general guidance”, indicazioni generali, non regole.
Per te che fotografi è una scorciatoia: non devi imparare un linguaggio nuovo, ce l’hai già. Prova a scrivere il prompt come scriveresti la scheda tecnica di uno scatto. Funziona uguale su altri modelli? Non so dirtelo con una fonte. Prova e confronta.
Leva 3: spegni il “bello” di default (Midjourney)
Se usi Midjourney, ricorda: V8.2 per scelta punta su “creative, bold, sophisticated, edgy”. Il default è già truccato.
Esiste una modalità Raw che toglie quasi tutta l’estetica di default. Secondo le guide che ho letto (MindStudio, marzo 2026, e il blog di Blake Crosley, agosto 2026) funziona, ma la sintassi è contesa: una guida scrive --style raw, l’altra, più recente, dice che su V8 il comando corretto è --raw e che il vecchio è un errore di migrazione frequente. I documenti ufficiali non si aprivano quando ho controllato, quindi verifica tu sul momento.
Poi c’è lo stylize, la manopola che decide quanto Midjourney metta del suo gusto. Va da 0 a 1000, il valore predefinito è 100. Secondo MindStudio, per il fotorealismo conviene stare tra 50 e 150, e uno stylize alto “often adds an artificial quality”, cioè tende ad aggiungere una qualità artificiale. Il consiglio è di provare lo stesso prompt a 50, 200 e 500 e confrontare. Sono indicazioni di una guida di terzi, non della documentazione ufficiale: usale come punto di partenza.
Un esercizio che puoi fare adesso: stesso prompt, tre valori, un’ora di tempo. Guarda cosa succede alla pelle e alla luce. Nel mio primo test di Midjourney V8 trovi il mio punto di partenza.
Leva 4: aggiungi la grana in post-produzione
Qui lavori fuori dal generatore, ed è la leva che per un fotografo è più naturale. In Lightroom, il pannello Grana ha tre controlli: Quantità (come l’effetto di un ISO alto), Dimensione (valori alti possono sfocare i dettagli fini) e Irregolarità (da liscia a grossolana). La descrizione viene da Digital Photography School, non da Adobe: la pagina non è datata e la documentazione Adobe non era raggiungibile.
Un chiarimento utile, sempre da dPS:
“Film grain gets a bad rap because it’s often confused with digital noise”
In italiano: la grana ha una cattiva fama perché la si confonde con il rumore digitale. La grana è la struttura delle particelle sensibili della pellicola, il rumore è un difetto dell’elettronica del sensore. Sembrano la stessa cosa, ma non lo sono, e a un’immagine sintetica la prima può servire, il secondo no.
Alza poco, guarda a 100%, poi guarda l’immagine ridotta come la vedrà chi la legge sul telefono.
Leva 5: codifica il tuo stile con esempi
L’ultima leva è la coerenza di brand, ed è il parallelo dei Brand Kit di Magnific One. Con i Custom Models di Adobe Firefly (beta pubblica da marzo 2026, secondo The Decoder) allarghi un modello con da 10 a 30 immagini tue, in JPG o PNG. I modelli sono privati per impostazione predefinita. Non riporto altri requisiti tecnici: non sono riuscito a verificarli.
Il principio vale anche senza Adobe: uno stile non lo descrivi a parole, lo mostri. Se hai un archivio di scatti tuoi, hai già il materiale più prezioso.
Dalla generazione alla direzione artistica
Rileggi le cinque leve. Luce con una sorgente, vocabolario di lenti e pellicole, un default spento, un po’ di grana, uno stile codificato con esempi. Nessuna è un tasto. Sono scelte, e a farle è chi ha un occhio.
Magnific One, Custom Models e Brand Kit provano a impacchettare queste scelte. Se funzionano (e, lo ripeto, il win rate è solo dichiarato e test di terzi non ne ho trovati) li userà meglio chi sa cosa vuole. Chi non lo sa otterrà un’altra patina, magari più sofisticata.
E se pensi: “quindi mi basta comprare lo strumento giusto”, la risposta è no. Anche se funzionasse davvero, decidere quale credibilità serve a quel brand, a quel cliente, a quella storia, resta una decisione umana.
Chiudo con le due cose da portarti a casa.
- Usa le cinque leve come checklist. Prendi un’immagine generata che non ti convince e prova a cambiare una leva alla volta: la luce, il vocabolario, lo stylize, la grana. Annota cosa cambia. In una settimana hai un metodo tuo, valido con Nano Banana, Midjourney, Firefly o quello che arriva dopo.
- Tieni separata la qualità dalla trasparenza. Rendere un’immagine più credibile è mestiere. Dire che l’hai fatta con l’AI è una scelta a parte, e le fonti che ho letto indicano proprio quella come leva di fiducia. Non delegarla al look.
Se hai già un tuo trucco per togliere la patina dalle immagini generate, scrivimelo nei commenti. Mi interessa soprattutto cosa funziona sulla pelle.
Luca
Articoli correlati
- Midjourney V8 è live: ecco le mie prime impressioni
- Rivoluzione nel Photo Editing: Come Integrare Nano Banana direttamente in Photoshop
- Non sai più se quello che vedi è vero, anche se credi di saperlo.
Fonti
- VentureBeat, Carl Franzen, lancio di Magnific One, 08/10/2026
- Creative AI News, Vannarot Roeung, 09/10/2026
- Midjourney, note di rilascio V8.2, 24/07/2026
- Google blog, Nano Banana Pro prompt tips, 20/11/2025
- Google Cloud, Image generation prompt guide (Imagen 3, Vertex AI)
- MindStudio, Luis Chavez-Mattos, 20/03/2026
- Blake Crosley, Midjourney V8 vs V7, 04/08/2026
- Digital Photography School, Adam Welch, grana in Lightroom (senza data)
- BeautyGRPO, arXiv 2603.01163, 01/03/2026
- DreamMakeup, arXiv 2510.10918, 13/10/2025
- RFSR, arXiv 2412.03268, 04/12/2024
- Taming Preference Mode Collapse, arXiv 2512.24146, CVPR 2026
- ContentGrip, Guess/Vogue, 05/08/2025
- B&T, Huffer, 09/06/2026
- Journal of Consumer Marketing 42(4), 11/06/2025
- St. Mary’s University, McNair Symposium 2025
- NBC News, McDonald’s NL, 11/12/2025
- The Decoder, Firefly Custom Models, 20/03/2026
- Tech.eu, rebrand Freepik in Magnific, 28/04/2026
- Sondaggi di parte su fiducia e annunci AI: MarTech / Canva 2026; Marketing Dive / Net Conversion; Marketing Brew / Harris-4As-Infillion (fonti ereditate dal registro del 15/10)
✍️ Articolo firmato da “La Redazione”: sistema editoriale multi-agente (AI) orchestrato con Claude Code e supervisionato da Luca Cazzaniga · lucacazzaniga.it
Leggi anche